吴恩达机器学习课程笔记
Week 1 · Lesson 1:Overview of Machine Learning(机器学习概览)
1. 什么是机器学习
机器学习(Machine Learning,ML)是一种让计算机从数据中学习规律,并利用学到的规律对新数据进行预测或决策的方法。
传统编程通常是:
输入:程序规则和数据
输出:结果
机器学习通常是:
输入:数据和正确答案,或只有数据
输出:从数据中学习到的模型
模型可以理解为一个函数,它把输入映射为输出:
f:X\rightarrow Y
训练模型的过程,就是根据已有数据找到合适的函数或参数。
2. 机器学习的应用
机器学习已经应用于许多领域,例如:
垃圾邮件识别
语音识别
图像识别与计算机视觉
推荐系统
医疗辅助诊断
自动驾驶
这些应用的共同点是:程序不一定需要由人手工写出所有规则,而是可以从大量数据中学习规律。
3. 机器学习项目的基本流程
一个机器学习项目通常包括:
收集和整理数据
明确需要预测或决策的目标
选择合适的机器学习方法
使用训练数据学习模型
在新数据上进行预测
评估模型效果并继续改进
机器学习的关键不只是写出一个程序,还要让模型在没有见过的新数据上表现良好。
4. 机器学习中的基本术语
样本(training example):一条训练数据
训练集(training set):用于训练模型的数据集合
特征(feature):描述样本的输入变量,例如面积、房间数、楼层
标签(label/target):需要预测的正确答案
模型(model):从输入到预测结果的函数
参数(parameter):模型中需要通过训练学习的数值
预测值(prediction):模型输出的结果,通常记为 \hat y
5. Lesson 1 核心思想
机器学习的核心是:
数据 → 学习模型 → 对新数据进行预测 \text{数据}\rightarrow\text{学习模型}\rightarrow\text{对新数据进行预测} 数据 → 学习模型 → 对新数据进行预测 与其为每个问题手工编写大量规则,不如让算法利用数据自动学习这些规则。
Week 1 · Lesson 2:Supervised vs. Unsupervised Machine Learning(监督学习与无监督学习)
1. 监督学习
监督学习(Supervised Learning)使用带有正确答案的数据进行训练。每个训练样本通常由输入和标签组成:
( x ( i ) , y ( i ) ) (x^{(i)},y^{(i)}) ( x ( i ) , y ( i ) ) 其中:
x^{(i)} 是第 i 个样本的输入
y^{(i)} 是第 i 个样本对应的正确答案,也叫标签
监督学习的目标是学习一个从 x 到 y 的映射,使模型能够对新的输入给出合理预测。
2. 监督学习的两个主要任务
2.1 回归(Regression)
回归用于预测连续数值,例如:
房屋价格
明天的气温
月度销售额
用户未来的消费金额
回归模型的输出通常是一个数值。例如输入房屋面积,输出预测价格。
2.2 分类(Classification)
分类用于预测离散类别,例如:
垃圾邮件或正常邮件
良性肿瘤或恶性肿瘤
猫、狗或鸟
用户是否会购买产品
分类问题的输出是类别,而不是任意连续数值。
3. 回归与分类的区别
两者都属于监督学习,都需要带标签的训练数据,但预测目标不同:
回归:预测连续数值
分类:预测有限个离散类别
例如,预测房价是回归问题;判断邮件是否为垃圾邮件是分类问题。
4. 无监督学习
无监督学习(Unsupervised Learning)只有输入数据,没有人为提供的正确标签:
x ( 1 ) , x ( 2 ) , … , x ( m ) x^{(1)},x^{(2)},\ldots,x^{(m)} x ( 1 ) , x ( 2 ) , … , x ( m ) 算法需要自己发现数据中的结构、分组或异常规律。
5. 无监督学习的常见任务
5.1 聚类(Clustering)
聚类是把相似的数据自动分到同一组。例如,根据用户行为把用户分成不同群体。算法并不知道每一组事先叫什么名字,而是根据数据的相似性自行发现分组。
5.2 异常检测(Anomaly Detection)
异常检测用于发现与大多数数据明显不同的样本,例如:
5.3 其他无监督任务
无监督学习还可以用于发现数据结构、压缩数据和降维。降维是在尽量保留重要信息的同时减少特征数量。
6. 监督学习与无监督学习的对比
对比项 监督学习 无监督学习 训练数据 有输入和正确标签 通常只有输入数据 学习目标 学习从输入到标签的映射 发现数据内部的结构 常见任务 回归、分类 聚类、异常检测、降维 例子 根据面积预测房价 根据用户行为自动分组
7. 训练集表示
在监督学习中,训练集可以表示为:
( x ( 1 ) , y ( 1 ) ) , ( x ( 2 ) , y ( 2 ) ) , … , ( x ( m ) , y ( m ) ) (x^{(1)},y^{(1)}),(x^{(2)},y^{(2)}),\ldots,(x^{(m)},y^{(m)}) ( x ( 1 ) , y ( 1 ) ) , ( x ( 2 ) , y ( 2 ) ) , … , ( x ( m ) , y ( m ) ) 其中 m 表示训练样本的数量。
训练的目标是让模型学会输入 x 与标签 y 之间的关系,而不是死记训练集中的每一条数据。
8. Jupyter Notebook
本课还介绍了 Jupyter Notebook,它是一种可以分块运行代码、查看结果和记录说明的交互式环境。
在机器学习学习和实验中,Jupyter Notebook 常用于:
编写和运行 Python 代码
查看数据与图像
逐步实验模型
记录实验过程和结论
它是实践工具,不是监督学习或无监督学习本身。
9. Lesson 2 核心思想
判断一个问题属于哪种学习方式,首先看训练数据是否包含标签:
有标签:通常是监督学习,再判断是回归还是分类
没有标签:通常是无监督学习,再寻找聚类、异常等数据结构
整个判断逻辑可以概括为:
\text{数据是否有正确答案?}
如果有,就学习输入到正确答案的映射;如果没有,就让算法发现数据本身的结构。
Week 1 · Lesson 3:Regression Model(回归模型)
1. 线性回归模型
线性回归(Linear Regression)用于预测连续数值。
当只有一个特征 x 时,模型可以用一条直线表示:
f w , b ( x ) = w x + b f_{w,b}(x)=wx+b f w , b ( x ) = w x + b 也可以写成:
y ^ = w x + b \hat y=wx+b y ^ = w x + b 其中:
x:输入特征,例如房屋面积
\hat y:预测值
w:权重,决定直线的斜率
b:偏置,决定直线在竖直方向上的平移
f_{w,b}(x):使用参数 w,b 时,模型对输入 x 的预测结果
例如,当 w=2,b=1 时:
f_{2,1}(x)=2x+1
当 x=3 时:
f_{2,1}(3)=2\times3+1=7
2. 代价函数
仅看某一个样本的预测结果,无法判断整个模型的好坏。需要一个函数,把所有训练样本的预测误差综合起来。
线性回归使用平方误差形式的代价函数:
J ( w , b ) = 1 2 m ∑ i = 1 m ( f w , b ( x ( i ) ) − y ( i ) ) 2 J(w,b)=\frac{1}{2m}\sum_{i=1}^{m}\left(f_{w,b}(x^{(i)})-y^{(i)}\right)^2 J ( w , b ) = 2 m 1 i = 1 ∑ m ( f w , b ( x ( i ) ) − y ( i ) ) 2 将模型函数代入后:
J ( w , b ) = 1 2 m ∑ i = 1 m ( w x ( i ) + b − y ( i ) ) 2 J(w,b)=\frac{1}{2m}\sum_{i=1}^{m}\left(wx^{(i)}+b-y^{(i)}\right)^2 J ( w , b ) = 2 m 1 i = 1 ∑ m ( w x ( i ) + b − y ( i ) ) 2 3. 逐项解释 J(w,b)
J(w,b):代价函数,输入参数 w,b,输出一个表示总体误差的数
m:训练样本的数量
i:第 i 个训练样本的编号
x^{(i)}:第 i 个样本的输入特征
y^{(i)}:第 i 个样本的真实标签
f_{w,b}(x^{(i)}):模型对第 i 个样本的预测值
f_{w,b}(x^{(i)})-y^{(i)}:预测误差
\left(f_{w,b}(x^{(i)})-y^{(i)}\right)^2:平方误差
注意,x^{(i)} 中的上标 (i) 表示样本编号,不表示 x 的 i 次方。
4. 为什么要平方、求和和取平均
平方的作用是:
使正误差和负误差都变成非负数,避免相互抵消
对较大的错误进行更强的惩罚
求和:
\sum_{i=1}^{m}
表示把所有训练样本的平方误差加起来。
除以 m 是为了计算平均误差,使代价不直接取决于样本数量。
前面的 \frac12 主要是为了求导方便,因为平方求导产生的系数 2 会与它抵消;它不改变最优参数的位置。
5. 代价函数的计算示例
假设训练集有两个样本:
( x ( 1 ) , y ( 1 ) ) = ( 1 , 2 ) , ( x ( 2 ) , y ( 2 ) ) = ( 2 , 4 ) (x^{(1)},y^{(1)})=(1,2),\qquad (x^{(2)},y^{(2)})=(2,4) ( x ( 1 ) , y ( 1 ) ) = ( 1 , 2 ) , ( x ( 2 ) , y ( 2 ) ) = ( 2 , 4 ) 因此:
m = 2 m=2 m = 2 假设当前模型参数为:
w = 1 , b = 0 w=1,\qquad b=0 w = 1 , b = 0 模型为:
f 1 , 0 ( x ) = x f_{1,0}(x)=x f 1 , 0 ( x ) = x 两个样本的平方误差分别为:
( f ( 1 ) − 2 ) 2 = ( 1 − 2 ) 2 = 1 (f(1)-2)^2=(1-2)^2=1 ( f ( 1 ) − 2 ) 2 = ( 1 − 2 ) 2 = 1 ( f ( 2 ) − 4 ) 2 = ( 2 − 4 ) 2 = 4 (f(2)-4)^2=(2-4)^2=4 ( f ( 2 ) − 4 ) 2 = ( 2 − 4 ) 2 = 4 代价函数为:
J ( 1 , 0 ) = 1 2 × 2 ( 1 + 4 ) = 5 4 = 1.25 J(1,0)=\frac{1}{2\times2}(1+4)=\frac54=1.25 J ( 1 , 0 ) = 2 × 2 1 ( 1 + 4 ) = 4 5 = 1.25 6. Lesson 3 相关目标
训练线性回归模型的目标是寻找一组参数,使代价函数尽可能小:
min w , b J ( w , b ) \min_{w,b}J(w,b) w , b min J ( w , b ) 因此:
f_{w,b}(x) 负责根据输入进行预测
J(w,b) 负责评价模型在训练集上的总体误差
w,b 是需要学习和调整的模型参数
Week 1 · Lesson 4:Train the model with gradient descent(使用梯度下降训练模型)
1. 梯度下降的目标
上一课已经定义了代价函数,并知道训练线性回归模型的目标是:
min w , b J ( w , b ) \min_{w,b}J(w,b) w , b min J ( w , b ) 梯度下降(Gradient Descent)是一种通过不断调整参数,使代价函数逐步减小的算法。
它要解决的问题是:已知当前的 w,b,应该向哪个方向调整,以及每次调整多少。
2. 梯度下降的基本思想
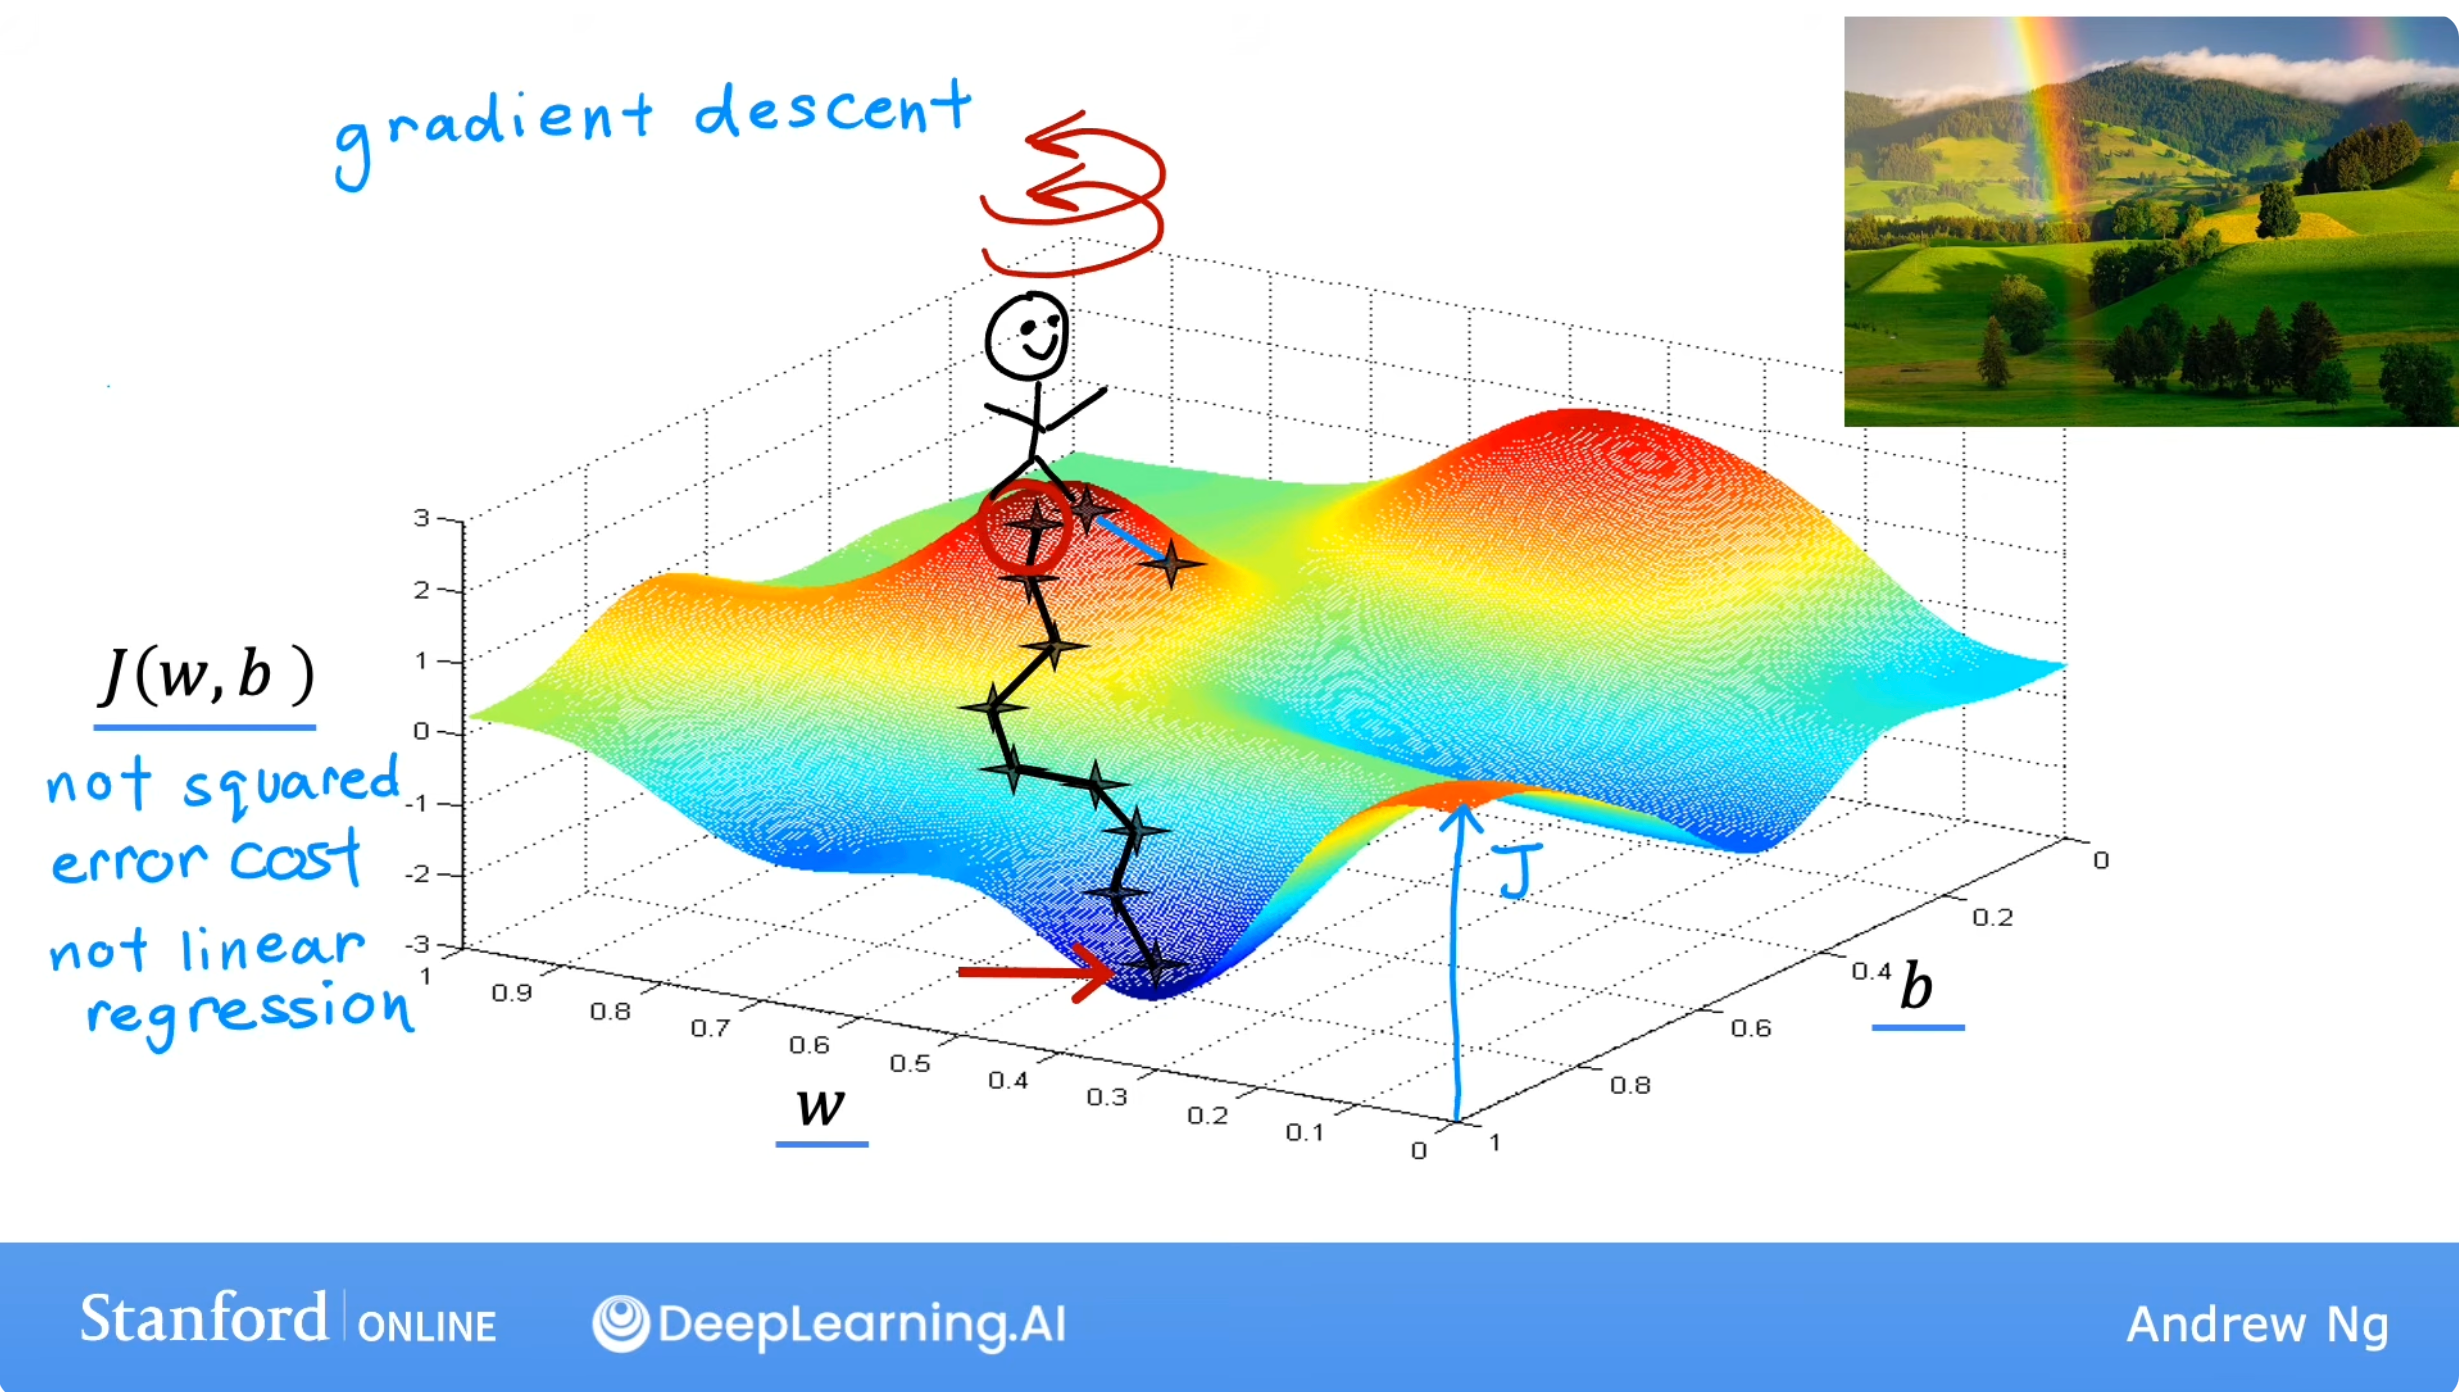
可以把代价函数想象成一座山:
山顶对应较大的代价
山谷对应较小的代价
最低点对应代价函数的最小值
梯度表示当前位置代价函数上升最快的方向。为了让代价下降,就要沿着梯度的反方向移动。
因此参数更新的一般形式是:
\text{新参数}=\text{旧参数}-\text{学习率}\times\text{梯度}
减号表示沿梯度的反方向移动,而不是表示参数一定变小。
3. 单变量线性回归的更新公式
对于模型:
f w , b ( x ) = w x + b f_{w,b}(x)=wx+b f w , b ( x ) = w x + b 代价函数为:
J ( w , b ) = 1 2 m ∑ i = 1 m ( f w , b ( x ( i ) ) − y ( i ) ) 2 J(w,b)=\frac{1}{2m}\sum_{i=1}^{m}\left(f_{w,b}(x^{(i)})-y^{(i)}\right)^2 J ( w , b ) = 2 m 1 i = 1 ∑ m ( f w , b ( x ( i ) ) − y ( i ) ) 2 梯度下降对 w 和 b 的更新公式分别为:
w : = w − α ∂ ∂ w J ( w , b ) w:=w-\alpha\frac{\partial}{\partial w}J(w,b) w := w − α ∂ w ∂ J ( w , b ) b : = b − α ∂ ∂ b J ( w , b ) b:=b-\alpha\frac{\partial}{\partial b}J(w,b) b := b − α ∂ b ∂ J ( w , b ) 其中:
\alpha:学习率(learning rate),决定每次移动的步长
\frac{\partial}{\partial w}J(w,b):代价函数对 w 的偏导数
\frac{\partial}{\partial b}J(w,b):代价函数对 b 的偏导数
:=,:赋值,用更新后的值替换旧值
4. 线性回归中的梯度公式
将代价函数求偏导,可以得到:
∂ J ( w , b ) ∂ w = 1 m ∑ i = 1 m ( f w , b ( x ( i ) ) − y ( i ) ) x ( i ) \frac{\partial J(w,b)}{\partial w}=\frac{1}{m}\sum_{i=1}^{m}\left(f_{w,b}(x^{(i)})-y^{(i)}\right)x^{(i)} ∂ w ∂ J ( w , b ) = m 1 i = 1 ∑ m ( f w , b ( x ( i ) ) − y ( i ) ) x ( i ) ∂ J ( w , b ) ∂ b = 1 m ∑ i = 1 m ( f w , b ( x ( i ) ) − y ( i ) ) \frac{\partial J(w,b)}{\partial b}=\frac{1}{m}\sum_{i=1}^{m}\left(f_{w,b}(x^{(i)})-y^{(i)}\right) ∂ b ∂ J ( w , b ) = m 1 i = 1 ∑ m ( f w , b ( x ( i ) ) − y ( i ) ) 因此,完整的梯度下降算法是:
w : = w − α [ 1 m ∑ i = 1 m ( f w , b ( x ( i ) ) − y ( i ) ) x ( i ) ] w:=w-\alpha\left[\frac{1}{m}\sum_{i=1}^{m}\left(f_{w,b}(x^{(i)})-y^{(i)}\right)x^{(i)}\right] w := w − α [ m 1 i = 1 ∑ m ( f w , b ( x ( i ) ) − y ( i ) ) x ( i ) ] b : = b − α [ 1 m ∑ i = 1 m ( f w , b ( x ( i ) ) − y ( i ) ) ] b:=b-\alpha\left[\frac{1}{m}\sum_{i=1}^{m}\left(f_{w,b}(x^{(i)})-y^{(i)}\right)\right] b := b − α [ m 1 i = 1 ∑ m ( f w , b ( x ( i ) ) − y ( i ) ) ] 5. 梯度公式的推导
令第 i 个样本的误差为:
e ( i ) = f w , b ( x ( i ) ) − y ( i ) e^{(i)}=f_{w,b}(x^{(i)})-y^{(i)} e ( i ) = f w , b ( x ( i ) ) − y ( i ) 则代价函数可以写成:
J ( w , b ) = 1 2 m ∑ i = 1 m ( e ( i ) ) 2 J(w,b)=\frac{1}{2m}\sum_{i=1}^{m}\left(e^{(i)}\right)^2 J ( w , b ) = 2 m 1 i = 1 ∑ m ( e ( i ) ) 2 对 w 求偏导时,使用链式法则:
∂ ∂ w 1 2 ( w x ( i ) + b − y ( i ) ) 2 = 1 2 × 2 ( w x ( i ) + b − y ( i ) ) x ( i ) \frac{\partial}{\partial w}\frac{1}{2}\left(wx^{(i)}+b-y^{(i)}\right)^2 =\frac{1}{2}\times2\left(wx^{(i)}+b-y^{(i)}\right)x^{(i)} ∂ w ∂ 2 1 ( w x ( i ) + b − y ( i ) ) 2 = 2 1 × 2 ( w x ( i ) + b − y ( i ) ) x ( i ) 于是:
∂ J ∂ w = 1 m ∑ i = 1 m ( w x ( i ) + b − y ( i ) ) x ( i ) \frac{\partial J}{\partial w}=\frac{1}{m}\sum_{i=1}^{m}\left(wx^{(i)}+b-y^{(i)}\right)x^{(i)} ∂ w ∂ J = m 1 i = 1 ∑ m ( w x ( i ) + b − y ( i ) ) x ( i ) 对 b 求偏导时:
∂ ∂ b ( w x ( i ) + b − y ( i ) ) = 1 \frac{\partial}{\partial b}\left(wx^{(i)}+b-y^{(i)}\right)=1 ∂ b ∂ ( w x ( i ) + b − y ( i ) ) = 1 所以:
∂ J ∂ b = 1 m ∑ i = 1 m ( w x ( i ) + b − y ( i ) ) \frac{\partial J}{\partial b}=\frac{1}{m}\sum_{i=1}^{m}\left(wx^{(i)}+b-y^{(i)}\right) ∂ b ∂ J = m 1 i = 1 ∑ m ( w x ( i ) + b − y ( i ) ) 这里的 \frac12 与平方求导产生的 2 相互抵消,这就是代价函数中加入 \frac12 的主要原因。
6. 为什么要同时更新 w 和 b
一次迭代中,应该先根据当前的 w,b 计算两个梯度,再同时更新两个参数:
t m p w = w − α ∂ J ∂ w tmp_w=w-\alpha\frac{\partial J}{\partial w} t m p w = w − α ∂ w ∂ J t m p b = b − α ∂ J ∂ b tmp_b=b-\alpha\frac{\partial J}{\partial b} t m p b = b − α ∂ b ∂ J 然后执行:
w : = t m p w w:=tmp_w w := t m p w b : = t m p b b:=tmp_b b := t m p b 不能先更新 w,再使用新的 w 去计算或更新 b,否则两个参数使用的不是同一个位置的梯度,算法就不再是标准的同步梯度下降。
7. 学习率 \alpha
学习率决定每次参数更新的大小。
7.1 学习率太小
每次移动步长很小
代价下降得很慢
需要更多迭代次数
7.2 学习率太大
可能越过最低点
代价函数可能上下震荡
甚至可能越来越大,导致算法发散
7.3 合适的学习率
代价通常随着迭代次数增加而下降
参数逐步接近使代价最小的位置
经过足够多次迭代后,参数基本稳定
学习率不是越大越好,也不是越小越好,需要根据数据规模和训练过程调整。
8. 梯度下降的一次计算示例
使用上一课的数据:
( x ( 1 ) , y ( 1 ) ) = ( 1 , 2 ) , ( x ( 2 ) , y ( 2 ) ) = ( 2 , 4 ) (x^{(1)},y^{(1)})=(1,2),\qquad(x^{(2)},y^{(2)})=(2,4) ( x ( 1 ) , y ( 1 ) ) = ( 1 , 2 ) , ( x ( 2 ) , y ( 2 ) ) = ( 2 , 4 ) 取当前参数:
w = 1 , b = 0 w=1,\qquad b=0 w = 1 , b = 0 模型预测:
f ( 1 ) = 1 , f ( 2 ) = 2 f(1)=1,\qquad f(2)=2 f ( 1 ) = 1 , f ( 2 ) = 2 两个样本的误差为:
e ( 1 ) = 1 − 2 = − 1 e^{(1)}=1-2=-1 e ( 1 ) = 1 − 2 = − 1 e ( 2 ) = 2 − 4 = − 2 e^{(2)}=2-4=-2 e ( 2 ) = 2 − 4 = − 2 计算关于 w 的梯度:
∂ J ∂ w = 1 2 [ ( − 1 ) × 1 + ( − 2 ) × 2 ] = − 2.5 \frac{\partial J}{\partial w}=\frac{1}{2}\left[(-1)\times1+(-2)\times2\right]=-2.5 ∂ w ∂ J = 2 1 [ ( − 1 ) × 1 + ( − 2 ) × 2 ] = − 2.5 计算关于 b 的梯度:
∂ J ∂ b = 1 2 ( − 1 − 2 ) = − 1.5 \frac{\partial J}{\partial b}=\frac{1}{2}(-1-2)=-1.5 ∂ b ∂ J = 2 1 ( − 1 − 2 ) = − 1.5 若学习率为:
α = 0.1 \alpha=0.1 α = 0.1 更新参数:
w : = 1 − 0.1 × ( − 2.5 ) = 1.25 w:=1-0.1\times(-2.5)=1.25 w := 1 − 0.1 × ( − 2.5 ) = 1.25 b : = 0 − 0.1 × ( − 1.5 ) = 0.15 b:=0-0.1\times(-1.5)=0.15 b := 0 − 0.1 × ( − 1.5 ) = 0.15 更新后的模型为:
f ( x ) = 1.25 x + 0.15 f(x)=1.25x+0.15 f ( x ) = 1.25 x + 0.15 代价从原来的:
J ( 1 , 0 ) = 1.25 J(1,0)=1.25 J ( 1 , 0 ) = 1.25 下降为:
J ( 1.25 , 0.15 ) = 0.545625 J(1.25,0.15)=0.545625 J ( 1.25 , 0.15 ) = 0.545625 代价变小,说明这次更新使模型变得更好。
9. 梯度下降的迭代过程
梯度下降不是只更新一次,而是重复执行以下步骤:
使用当前 w,b 计算所有样本的预测值
计算每个样本的误差
计算关于 w,b 的平均梯度
使用学习率更新 w,b
重新计算代价函数
重复以上步骤,直到满足停止条件
伪代码为:
w = initial_w
b = initial_b

for step in range(num_iterations):
    predictions = w * x + b
    errors = predictions - y
    dj_dw = (1 / m) * sum(errors * x)
    dj_db = (1 / m) * sum(errors)
    w = w - alpha * dj_dw
    b = b - alpha * dj_db
实际使用 NumPy 时,可以利用向量化运算避免逐个样本编写循环。
10. 什么时候停止迭代
常见停止条件包括:
达到预先设置的最大迭代次数
相邻两次代价函数的变化非常小
参数变化非常小
梯度的绝对值足够接近 0
对于线性回归的平方误差代价函数,只要学习率合适,代价通常会逐步接近最小值。
11. 线性回归中的局部最小值问题
梯度下降有时会受到局部最小值的影响,但对于单变量线性回归使用平方误差时,代价函数通常是一个凸函数:
代价函数的图像类似碗形
凸函数的局部最小值也是全局最小值
从不同的初始参数出发,理论上都可以到达同一个全局最小值
因此,线性回归中的梯度下降相对容易理解。复杂的非凸模型可能存在多个局部低点、鞍点或平坦区域。
12. 参数空间中的梯度下降
当只有一个参数 w 时,可以画出 J(w) 关于 w 的曲线;当有 w,b 两个参数时,可以把代价函数看成三维曲面:
J(w,b)
其中:
横轴可以表示 w
纵轴可以表示 b
高度表示代价 J(w,b)
梯度下降会沿着曲面下降最快的方向移动,直到接近最低点。
参数空间中的移动轨迹表示参数如何变化,而训练数据图中的直线变化表示模型如何逐渐拟合数据。
13. 批量梯度下降
上面的公式每次更新都使用全部 m 个训练样本:
1 m ∑ i = 1 m \frac{1}{m}\sum_{i=1}^{m} m 1 i = 1 ∑ m 这种方法叫批量梯度下降(Batch Gradient Descent)。吴恩达课程在介绍线性回归时主要使用这种形式。
批量梯度下降的特点:
每次更新方向比较稳定
每轮都要遍历全部训练数据
数据量很大时,单次更新成本较高
14. 梯度下降与代价函数的关系
梯度下降不是代价函数,也不是模型本身:
f_{w,b}(x):模型,用于预测
J(w,b):代价函数,用于衡量模型好坏
梯度:告诉我们代价增加最快的方向
梯度下降:利用梯度反方向更新参数的优化算法
完整逻辑是:
\text{模型}\rightarrow\text{预测}\rightarrow\text{代价}\rightarrow\text{梯度}\rightarrow\text{参数更新}
15. Lesson 4 核心公式
模型函数:
f w , b ( x ) = w x + b f_{w,b}(x)=wx+b f w , b ( x ) = w x + b 代价函数:
J ( w , b ) = 1 2 m ∑ i = 1 m ( f w , b ( x ( i ) ) − y ( i ) ) 2 J(w,b)=\frac{1}{2m}\sum_{i=1}^{m}\left(f_{w,b}(x^{(i)})-y^{(i)}\right)^2 J ( w , b ) = 2 m 1 i = 1 ∑ m ( f w , b ( x ( i ) ) − y ( i ) ) 2 梯度下降更新:
w : = w − α ∂ J ( w , b ) ∂ w w:=w-\alpha\frac{\partial J(w,b)}{\partial w} w := w − α ∂ w ∂ J ( w , b ) b : = b − α ∂ J ( w , b ) ∂ b b:=b-\alpha\frac{\partial J(w,b)}{\partial b} b := b − α ∂ b ∂ J ( w , b ) 线性回归的梯度:
∂ J ( w , b ) ∂ w = 1 m ∑ i = 1 m ( f w , b ( x ( i ) ) − y ( i ) ) x ( i ) \frac{\partial J(w,b)}{\partial w}=\frac{1}{m}\sum_{i=1}^{m}\left(f_{w,b}(x^{(i)})-y^{(i)}\right)x^{(i)} ∂ w ∂ J ( w , b ) = m 1 i = 1 ∑ m ( f w , b ( x ( i ) ) − y ( i ) ) x ( i ) ∂ J ( w , b ) ∂ b = 1 m ∑ i = 1 m ( f w , b ( x ( i ) ) − y ( i ) ) \frac{\partial J(w,b)}{\partial b}=\frac{1}{m}\sum_{i=1}^{m}\left(f_{w,b}(x^{(i)})-y^{(i)}\right) ∂ b ∂ J ( w , b ) = m 1 i = 1 ∑ m ( f w , b ( x ( i ) ) − y ( i ) ) Week 1 总结
监督学习 → 线性回归 → 代价函数 → 梯度下降 \text{监督学习}\rightarrow\text{线性回归}\rightarrow\text{代价函数}\rightarrow\text{梯度下降} 监督学习 → 线性回归 → 代价函数 → 梯度下降 监督学习提供带标签的数据,线性回归建立预测模型,代价函数衡量模型误差,梯度下降不断调整参数,使代价函数逐渐减小。
Week 2 · Lesson 1:Multiple linear regression(多元线性回归)
1. 从单变量线性回归到多元线性回归
Week 1 中的单变量线性回归只有一个特征:
f w , b ( x ) = w x + b f_{w,b}(x)=wx+b f w , b ( x ) = w x + b 现实问题通常同时拥有多个特征。例如预测房价时,除了房屋面积,还可能使用卧室数量、楼层数和房龄等信息。
多元线性回归(Multiple Linear Regression)就是使用多个输入特征预测一个连续输出值的回归模型。
2. 训练样本的表示
假设每个样本有 n 个特征,第 i 个样本可以表示为:
x ( i ) = [ x 1 ( i ) x 2 ( i ) v d o t s x n ( i ) ] x^{(i)}=\begin{bmatrix}x_1^{(i)}\\x_2^{(i)}\\vdots\\x_n^{(i)}\end{bmatrix} x ( i ) = x 1 ( i ) x 2 ( i ) v d o t s x n ( i ) 其中:
x_j^{(i)}:第 i 个样本的第 j 个特征
x^{(i)}:第 i 个样本的全部特征
n:特征数量
m:训练样本数量
y^{(i)}:第 i 个样本的真实标签
需要注意:
上标 (i) 表示样本编号
下标 j 表示特征编号
x_j^{(i)} 不是幂,而是一个特征的编号表示
3. 多元线性回归模型
多元线性回归模型为:
f w ⃗ , b ( x ⃗ ) = w 1 x 1 + w 2 x 2 + ⋯ + w n x n + b f_{\vec w,b}(\vec x)=w_1x_1+w_2x_2+\cdots+w_nx_n+b f w , b ( x ) = w 1 x 1 + w 2 x 2 + ⋯ + w n x n + b 使用求和符号表示为:
f w ⃗ , b ( x ⃗ ) = ∑ j = 1 n w j x j + b f_{\vec w,b}(\vec x)=\sum_{j=1}^{n}w_jx_j+b f w , b ( x ) = j = 1 ∑ n w j x j + b 其中:
\vec x:由 n 个特征组成的输入向量
\vec w:由 n 个权重组成的参数向量
w_j:第 j 个特征对应的权重
b:偏置项
f_{\vec w,b}(\vec x):模型预测值
与单变量模型相比,变化在于模型不再只有一个权重 w,而是有一组权重 w_1,w_2,\ldots,w_n。
4. 模型的直观含义
假设模型使用三个特征:
x_1:房屋面积
x_2:卧室数量
x_3:房屋楼层
模型可以写成:
f_{\vec w,b}(\vec x)=w_1x_1+w_2x_2+w_3x_3+b
每个权重表示对应特征对预测结果的影响方向和相对大小:
w_j>0:在其他特征不变时,增大 x_j 通常会使预测值增大
w_j<0:在其他特征不变时,增大 x_j 通常会使预测值减小
|w_j| 较大:模型对该特征的数值变化更敏感
但不同特征的单位和尺度可能不同,不能只根据权重绝对值直接判断特征的重要性。
5. 向量形式
把所有特征和权重分别写成向量:
x ⃗ = [ x 1 x 2 v d o t s x n ] , w ⃗ = [ w 1 w 2 v d o t s w n ] \vec x=\begin{bmatrix}x_1\\x_2\\vdots\\x_n\end{bmatrix},\qquad \vec w=\begin{bmatrix}w_1\\w_2\\vdots\\w_n\end{bmatrix} x = x 1 x 2 v d o t s x n , w = w 1 w 2 v d o t s w n 模型可以写成向量点积形式:
f w ⃗ , b ( x ⃗ ) = w ⃗ ⋅ x ⃗ + b f_{\vec w,b}(\vec x)=\vec w\cdot\vec x+b f w , b ( x ) = w ⋅ x + b 点积展开后就是:
w ⃗ ⋅ x ⃗ = w 1 x 1 + w 2 x 2 + ⋯ + w n x n \vec w\cdot\vec x=w_1x_1+w_2x_2+\cdots+w_nx_n w ⋅ x = w 1 x 1 + w 2 x 2 + ⋯ + w n x n 因此,下面三种写法表示同一个模型:
f w ⃗ , b ( x ⃗ ) = w 1 x 1 + ⋯ + w n x n + b f_{\vec w,b}(\vec x)=w_1x_1+\cdots+w_nx_n+b f w , b ( x ) = w 1 x 1 + ⋯ + w n x n + b f w ⃗ , b ( x ⃗ ) = ∑ j = 1 n w j x j + b f_{\vec w,b}(\vec x)=\sum_{j=1}^{n}w_jx_j+b f w , b ( x ) = j = 1 ∑ n w j x j + b f w ⃗ , b ( x ⃗ ) = w ⃗ ⋅ x ⃗ + b f_{\vec w,b}(\vec x)=\vec w\cdot\vec x+b f w , b ( x ) = w ⋅ x + b 向量形式能够使公式更简洁,也便于使用 NumPy 进行向量化计算。
6. 参数和输入的维度
当有 n 个特征时:
\vec x 是 n 维向量
\vec w 是 n 维向量
\vec w\cdot\vec x 是一个标量
b 是一个标量
因此:
(n\text{维向量})\cdot(n\text{维向量})+\text{标量}=\text{标量}
模型最终输出一个预测值,而不是一个向量。
7. 多元线性回归的代价函数
多元线性回归仍然使用平方误差代价函数:
J ( w ⃗ , b ) = 1 2 m ∑ i = 1 m ( f w ⃗ , b ( x ⃗ ( i ) ) − y ( i ) ) 2 J(\vec w,b)=\frac{1}{2m}\sum_{i=1}^{m}\left(f_{\vec w,b}(\vec x^{(i)})-y^{(i)}\right)^2 J ( w , b ) = 2 m 1 i = 1 ∑ m ( f w , b ( x ( i ) ) − y ( i ) ) 2 将模型展开后:
J ( w ⃗ , b ) = 1 2 m ∑ i = 1 m ( ∑ j = 1 n w j x j ( i ) + b − y ( i ) ) 2 J(\vec w,b)=\frac{1}{2m}\sum_{i=1}^{m}\left(\sum_{j=1}^{n}w_jx_j^{(i)}+b-y^{(i)}\right)^2 J ( w , b ) = 2 m 1 i = 1 ∑ m ( j = 1 ∑ n w j x j ( i ) + b − y ( i ) ) 2 与单变量线性回归相比,代价函数的结构没有改变,改变的是每个样本的预测公式由一个特征扩展成了多个特征。
训练目标仍然是:
min w ⃗ , b J ( w ⃗ , b ) \min_{\vec w,b}J(\vec w,b) w , b min J ( w , b ) 8. 多元线性回归的梯度下降
对每一个权重 w_j,梯度下降更新公式为:
w j : = w j − α ∂ ∂ w j J ( w ⃗ , b ) w_j:=w_j-\alpha\frac{\partial}{\partial w_j}J(\vec w,b) w j := w j − α ∂ w j ∂ J ( w , b ) 对偏置 b 的更新公式为:
b : = b − α ∂ ∂ b J ( w ⃗ , b ) b:=b-\alpha\frac{\partial}{\partial b}J(\vec w,b) b := b − α ∂ b ∂ J ( w , b ) 对应的梯度为:
∂ J ( w ⃗ , b ) ∂ w j = 1 m ∑ i = 1 m ( f w ⃗ , b ( x ⃗ ( i ) ) − y ( i ) ) x j ( i ) \frac{\partial J(\vec w,b)}{\partial w_j}=\frac{1}{m}\sum_{i=1}^{m}\left(f_{\vec w,b}(\vec x^{(i)})-y^{(i)}\right)x_j^{(i)} ∂ w j ∂ J ( w , b ) = m 1 i = 1 ∑ m ( f w , b ( x ( i ) ) − y ( i ) ) x j ( i ) ∂ J ( w ⃗ , b ) ∂ b = 1 m ∑ i = 1 m ( f w ⃗ , b ( x ⃗ ( i ) ) − y ( i ) ) \frac{\partial J(\vec w,b)}{\partial b}=\frac{1}{m}\sum_{i=1}^{m}\left(f_{\vec w,b}(\vec x^{(i)})-y^{(i)}\right) ∂ b ∂ J ( w , b ) = m 1 i = 1 ∑ m ( f w , b ( x ( i ) ) − y ( i ) ) 因此完整更新为:
w j : = w j − α [ 1 m ∑ i = 1 m ( f w ⃗ , b ( x ⃗ ( i ) ) − y ( i ) ) x j ( i ) ] w_j:=w_j-\alpha\left[\frac{1}{m}\sum_{i=1}^{m}\left(f_{\vec w,b}(\vec x^{(i)})-y^{(i)}\right)x_j^{(i)}\right] w j := w j − α [ m 1 i = 1 ∑ m ( f w , b ( x ( i ) ) − y ( i ) ) x j ( i ) ] b : = b − α [ 1 m ∑ i = 1 m ( f w ⃗ , b ( x ⃗ ( i ) ) − y ( i ) ) ] b:=b-\alpha\left[\frac{1}{m}\sum_{i=1}^{m}\left(f_{\vec w,b}(\vec x^{(i)})-y^{(i)}\right)\right] b := b − α [ m 1 i = 1 ∑ m ( f w , b ( x ( i ) ) − y ( i ) ) ] 这里的 j 从 1 到 n,表示需要对每一个权重分别计算并更新一次。
9. 多个参数需要同步更新
在一次梯度下降迭代中,所有 w_j 和 b 都应该根据更新前的参数计算梯度,然后同时更新:
w j n e w = w j − α ∂ J ∂ w j w_j^{\mathrm{new}}=w_j-\alpha\frac{\partial J}{\partial w_j} w j new = w j − α ∂ w j ∂ J b n e w = b − α ∂ J ∂ b b^{\mathrm{new}}=b-\alpha\frac{\partial J}{\partial b} b new = b − α ∂ b ∂ J 不能先用更新后的 w_1 去计算 w_2 的梯度,也不能在更新了部分参数后改变其他参数的梯度计算位置。
同步更新的本质是:所有参数从同一个参数点出发,沿该点的梯度反方向移动。
10. 一个三特征模型的计算示例
假设只有一个样本,输入为:
x ⃗ = [ 2 3 1 ] , y = 10 \vec x=\begin{bmatrix}2\\3\\1\end{bmatrix},\qquad y=10 x = 2 3 1 , y = 10 参数为:
w ⃗ = [ 1 2 1 ] , b = 1 \vec w=\begin{bmatrix}1\\2\\1\end{bmatrix},\qquad b=1 w = 1 2 1 , b = 1 预测值为:
f w ⃗ , b ( x ⃗ ) = 1 × 2 + 2 × 3 + 1 × 1 + 1 = 10 f_{\vec w,b}(\vec x)=1\times2+2\times3+1\times1+1=10 f w , b ( x ) = 1 × 2 + 2 × 3 + 1 × 1 + 1 = 10 因此误差为:
f w ⃗ , b ( x ⃗ ) − y = 10 − 10 = 0 f_{\vec w,b}(\vec x)-y=10-10=0 f w , b ( x ) − y = 10 − 10 = 0 这个样本在当前参数下被准确预测。实际训练中通常有多个样本,模型会根据所有样本的平均误差更新参数。
11. 多元线性回归的向量化计算
对于单个样本,预测可以写成:
prediction = w @ x + b 其中 @ 表示向量点积。
使用 NumPy 时:
import numpy as np

x = np.array([2, 3, 1])
w = np.array([1, 2, 1])
b = 1

prediction = w @ x + b
print(prediction)
输出为:
10 向量化的优势是:
代码更简洁
减少 Python 层循环
通常运行更快
更容易扩展到多个特征和大量样本
12. 多元线性回归与单变量线性回归的关系
单变量线性回归是多元线性回归在 n=1 时的特殊情况:
f w , b ( x ) = w x + b f_{w,b}(x)=wx+b f w , b ( x ) = w x + b 多元线性回归只是把一个特征扩展为多个特征:
f w ⃗ , b ( x ⃗ ) = w ⃗ ⋅ x ⃗ + b f_{\vec w,b}(\vec x)=\vec w\cdot\vec x+b f w , b ( x ) = w ⋅ x + b 二者使用相同的核心思想:
模型 → 代价函数 → 梯度下降 \text{模型}\rightarrow\text{代价函数}\rightarrow\text{梯度下降} 模型 → 代价函数 → 梯度下降 13. 多元线性回归中的注意事项
特征数量增加后,参数数量也会增加
不同特征的单位和数值范围可能差异很大
特征之间可能存在相关性
特征数量过多可能导致模型过拟合
梯度下降仍然需要选择合适的学习率
使用向量化实现时要确认向量维度一致
训练数据中的缺失值、异常值和错误单位会影响模型
特征缩放、特征工程和正则化会在后续内容中进一步处理。
14. Week 2 · Lesson 1 核心公式
多元线性回归模型:
f w ⃗ , b ( x ⃗ ) = ∑ j = 1 n w j x j + b f_{\vec w,b}(\vec x)=\sum_{j=1}^{n}w_jx_j+b f w , b ( x ) = j = 1 ∑ n w j x j + b 向量形式:
f w ⃗ , b ( x ⃗ ) = w ⃗ ⋅ x ⃗ + b f_{\vec w,b}(\vec x)=\vec w\cdot\vec x+b f w , b ( x ) = w ⋅ x + b 代价函数:
J ( w ⃗ , b ) = 1 2 m ∑ i = 1 m ( f w ⃗ , b ( x ⃗ ( i ) ) − y ( i ) ) 2 J(\vec w,b)=\frac{1}{2m}\sum_{i=1}^{m}\left(f_{\vec w,b}(\vec x^{(i)})-y^{(i)}\right)^2 J ( w , b ) = 2 m 1 i = 1 ∑ m ( f w , b ( x ( i ) ) − y ( i ) ) 2 权重更新:
w j : = w j − α ∂ J ( w ⃗ , b ) ∂ w j w_j:=w_j-\alpha\frac{\partial J(\vec w,b)}{\partial w_j} w j := w j − α ∂ w j ∂ J ( w , b ) 偏置更新:
b : = b − α ∂ J ( w ⃗ , b ) ∂ b b:=b-\alpha\frac{\partial J(\vec w,b)}{\partial b} b := b − α ∂ b ∂ J ( w , b ) 15. Week 2 · Lesson 1 总结
多元线性回归使用多个特征共同预测一个连续数值。与单变量线性回归相比,模型从 wx+b 扩展为 \vec w\cdot\vec x+b,代价函数和梯度下降的基本思想保持不变,只是需要对每一个权重 w_j 分别计算梯度并同步更新。
Week 2 · Lesson 2:Gradient descent in practice(梯度下降实践)
1. 为什么需要在实践中改进梯度下降
多元线性回归的特征可能使用完全不同的单位和数值范围。例如:
房屋面积可能是 50 到 300
卧室数量可能是 1 到 6
房龄可能是 0 到 100
如果不同特征的尺度差异很大,代价函数的等高线可能会非常狭长。梯度下降会在狭长的等高线中反复横向摆动,导致:
收敛速度变慢
对学习率更敏感
需要更多迭代次数
甚至可能因为学习率过大而发散
在实践中,通常需要先进行特征缩放,再运行梯度下降。
2. 特征缩放
特征缩放(Feature Scaling)是把不同特征转换到相近的数值范围,使梯度下降更容易工作。
原始特征记为 x_j,缩放后的特征记为 x_j^{\mathrm{scaled}}。
常见目标是让大多数特征位于大约 -1 到 1 的范围内,或者至少让各个特征的数量级比较接近。
特征缩放不会改变数据中样本之间的关系,只是改变特征的表示尺度。
3. 最大值最小值缩放
一种简单的缩放方法是 Min-Max Scaling:
x j s c a l e d = x j − min ( x j ) max ( x j ) − min ( x j ) x_j^{\mathrm{scaled}}=\frac{x_j-\min(x_j)}{\max(x_j)-\min(x_j)} x j scaled = max ( x j ) − min ( x j ) x j − min ( x j ) 缩放后通常位于 [0,1] 区间。
它适合特征具有明确上下界的情况,但如果新数据超出训练集的最大值或最小值,缩放后的数值可能超出 [0,1]。
4. 均值归一化
均值归一化(Mean Normalization)可以写成:
x j s c a l e d = x j − μ j max ( x j ) − min ( x j ) x_j^{\mathrm{scaled}}=\frac{x_j-\mu_j}{\max(x_j)-\min(x_j)} x j scaled = max ( x j ) − min ( x j ) x j − μ j 其中:
\mu_j:第 j 个特征在训练集上的平均值
\max(x_j):第 j 个特征在训练集上的最大值
\min(x_j):第 j 个特征在训练集上的最小值
这种方法会把特征中心移动到接近 0 的位置。
5. Z-score 标准化
Z-score 标准化是实践中常见的方法:
x j s c a l e d = x j − μ j σ j x_j^{\mathrm{scaled}}=\frac{x_j-\mu_j}{\sigma_j} x j scaled = σ j x j − μ j 其中:
\mu_j:第 j 个特征的训练集均值
\sigma_j:第 j 个特征的训练集标准差
标准化后,特征通常以 0 为中心,标准差约为 1。
如果一个特征的标准化结果大多数落在 -3 到 3 之间,通常可以认为缩放效果比较合理;这不是必须满足的硬性规则,而是检查尺度是否异常的经验方法。
6. 特征缩放的正确流程
特征缩放参数必须只使用训练集计算:
在训练集上计算每个特征的 \mu_j、\sigma_j 或最大最小值
使用这些参数转换训练集
使用完全相同的参数转换验证集、测试集和新输入
训练模型和进行预测
不能为测试集单独重新计算均值和标准差,否则训练过程和预测过程使用了不同的坐标尺度,还可能造成数据泄漏。
例如,若训练集得到:
\mu_j=100,\qquad\sigma_j=20
新样本的特征值为 140,则必须使用训练集参数:
x_j^{\mathrm{scaled}}=\frac{140-100}{20}=2
不能使用新样本或测试集重新计算 \mu_j 和 \sigma_j。
7. 特征缩放与模型参数
使用缩放后的特征训练模型时,模型变为:
f w ⃗ , b ( x ⃗ s c a l e d ) = w ⃗ ⋅ x ⃗ s c a l e d + b f_{\vec w,b}(\vec x^{\mathrm{scaled}})=\vec w\cdot\vec x^{\mathrm{scaled}}+b f w , b ( x scaled ) = w ⋅ x scaled + b 这时的权重对应的是缩放后的特征,而不是原始单位下的特征。
因此,不能直接拿缩放模型中的权重与未缩放模型中的权重比较。权重大小受到特征单位、缩放方式和数据分布的影响。
8. 梯度下降中的学习率
学习率 \alpha 决定每次参数更新的步长:
θ : = θ − α ∂ J ∂ θ \theta:=\theta-\alpha\frac{\partial J}{\partial\theta} θ := θ − α ∂ θ ∂ J 在多元线性回归中,\theta 可以代表每一个 w_j 或 b。
学习率过小
代价函数下降缓慢
需要很多次迭代
在固定迭代次数下可能还没有收敛
学习率过大
代价函数可能上下震荡
代价可能越来越大
参数可能远离最优点,算法发散
学习率合适
代价函数总体下降
下降速度较稳定
经过足够多次迭代后变化趋于平缓
9. 如何判断梯度下降是否收敛
可以记录每次迭代的代价函数:
J ( t ) = J ( w ⃗ ( t ) , b ( t ) ) J^{(t)}=J(\vec w^{(t)},b^{(t)}) J ( t ) = J ( w ( t ) , b ( t ) ) 然后绘制“迭代次数—代价函数”曲线。
常见判断方法包括:
代价函数持续下降并趋于稳定
相邻两次代价变化小于阈值 \varepsilon
梯度的大小接近 0
参数变化小于设定阈值
常用的收敛判断形式是:
\left|J^{(t+1)}-J^{(t)}\right|<\varepsilon
实际训练中通常同时设置最大迭代次数,防止程序因为异常情况无限运行。
10. 选择学习率的实践方法
可以尝试一组由小到大的候选值,例如:
0.001 , 0.003 , 0.01 , 0.03 , 0.1 0.001,\quad0.003,\quad0.01,\quad0.03,\quad0.1 0.001 , 0.003 , 0.01 , 0.03 , 0.1 对每个学习率观察代价曲线:
曲线下降非常慢:学习率可能太小
曲线明显震荡或上升:学习率可能太大
曲线稳定下降并较快趋于平稳:学习率较合适
特征缩放后,各个特征的尺度更接近,通常更容易找到合适的学习率。
11. 特征工程
特征工程(Feature Engineering)是根据领域知识构造更有用的特征。
原始特征不一定是最适合模型学习的形式。例如房屋预测中,房屋长和宽分别作为特征时,可以构造房屋面积:
x a r e a = x l e n g t h × x w i d t h x_{\mathrm{area}}=x_{\mathrm{length}}\times x_{\mathrm{width}} x area = x length × x width 模型可以改为:
f w ⃗ , b ( x ⃗ ) = w 1 x l e n g t h + w 2 x w i d t h + w 3 x a r e a + b f_{\vec w,b}(\vec x)=w_1x_{\mathrm{length}}+w_2x_{\mathrm{width}}+w_3x_{\mathrm{area}}+b f w , b ( x ) = w 1 x length + w 2 x width + w 3 x area + b 特征工程的目标不是盲目增加特征,而是把问题中有意义的关系提供给模型。
12. 多项式回归
通过对原始特征进行变换,可以让线性回归拟合曲线。
例如,使用一个输入特征 x,构造:
x 1 = x , x 2 = x 2 , x 3 = x 3 x_1=x,\qquad x_2=x^2,\qquad x_3=x^3 x 1 = x , x 2 = x 2 , x 3 = x 3 模型为:
f w ⃗ , b ( x ⃗ ) = w 1 x + w 2 x 2 + w 3 x 3 + b f_{\vec w,b}(\vec x)=w_1x+w_2x^2+w_3x^3+b f w , b ( x ) = w 1 x + w 2 x 2 + w 3 x 3 + b 虽然这个模型对原始输入 x 来说是曲线,但它对参数 w_1,w_2,w_3,b 仍然是线性的,因此仍然可以使用线性回归和梯度下降训练。
“线性回归”中的线性,主要指模型对参数是线性的,不一定意味着最终画出来的曲线必须是一条直线。
13. 多项式特征的缩放
多项式特征很容易产生更大的数值范围。例如,当 x 较大时,x^2 和 x^3 会迅速增大。
如果直接使用:
x , x 2 , x 3 x,\quad x^2,\quad x^3 x , x 2 , x 3 不同特征的尺度可能差异很大,梯度下降会变慢甚至不稳定。
因此,构造多项式特征后,通常还需要对这些新特征进行特征缩放。
推荐流程是:
构造特征
在训练集上计算缩放参数
缩放构造后的全部特征
运行梯度下降
对新样本执行完全相同的特征构造和缩放
14. 梯度下降实践中的完整流程
对于多元线性回归,一个较完整的训练流程是:
收集训练数据
检查每个特征的单位和数值范围
进行特征工程
划分训练集、验证集和测试集
只使用训练集计算特征缩放参数
转换训练、验证、测试数据
初始化 \vec w,b
选择学习率 \alpha 和迭代次数
执行梯度下降
绘制代价曲线检查收敛
在验证集上评估模型
使用测试集进行最终评估
对新数据执行相同的特征处理并预测
Week 2 总结
多元线性回归 → 特征缩放 → 学习率检查 → 特征工程 → 多项式回归 \text{多元线性回归}\rightarrow\text{特征缩放}\rightarrow\text{学习率检查}\rightarrow\text{特征工程}\rightarrow\text{多项式回归} 多元线性回归 → 特征缩放 → 学习率检查 → 特征工程 → 多项式回归 Week 2 将单变量线性回归扩展到多个输入特征,并进一步讨论如何让梯度下降在真实数据上更稳定、更快速地工作。
核心流程是:
构造特征 → 缩放特征 → 运行梯度下降 → 检查收敛 → 评估模型 \text{构造特征}\rightarrow\text{缩放特征}\rightarrow\text{运行梯度下降}\rightarrow\text{检查收敛}\rightarrow\text{评估模型} 构造特征 → 缩放特征 → 运行梯度下降 → 检查收敛 → 评估模型 Week 3 · Lesson 1:Classification with logistic regression(使用逻辑回归进行分类)
1. 分类问题
分类(Classification)是预测离散类别,而不是预测连续数值。
二分类问题中,标签通常只有两个取值:
y ∈ 0 , 1 y\in{0,1} y ∈ 0 , 1 例如:
y=1:邮件是垃圾邮件
y=0:邮件不是垃圾邮件
y=1:肿瘤是恶性
y=0:肿瘤是良性
逻辑回归(Logistic Regression)虽然名字中有“回归”,但它主要用于分类问题。
2. 为什么不能直接使用线性回归做分类
如果直接使用线性回归:
f w ⃗ , b ( x ⃗ ) = w ⃗ ⋅ x ⃗ + b f_{\vec w,b}(\vec x)=\vec w\cdot\vec x+b f w , b ( x ) = w ⋅ x + b 把预测值大于 0.5 判断为类别 1,把预测值小于 0.5 判断为类别 0,可能会遇到问题:
预测值可能小于 0 或大于 1,不能自然地解释为概率
分类标签只有 0 和 1,线性回归的连续数值假设并不合适
加入一个远离其他样本的异常点后,拟合直线可能发生明显变化
分类数据的决策边界和连续数值预测的目标不同
因此,需要一个函数把任意实数压缩到 0 和 1 之间,这个函数就是 Sigmoid 函数。
3. 逻辑回归模型的两步结构
逻辑回归可以拆成两步:
第一步,先计算线性组合:
z = w ⃗ ⋅ x ⃗ + b z=\vec w\cdot\vec x+b z = w ⋅ x + b 展开为:
z = w 1 x 1 + w 2 x 2 + ⋯ + w n x n + b z=w_1x_1+w_2x_2+\cdots+w_nx_n+b z = w 1 x 1 + w 2 x 2 + ⋯ + w n x n + b 第二步,把 z 输入 Sigmoid 函数:
f w ⃗ , b ( x ⃗ ) = g ( z ) f_{\vec w,b}(\vec x)=g(z) f w , b ( x ) = g ( z ) 因此完整模型为:
f w ⃗ , b ( x ⃗ ) = g ( w ⃗ ⋅ x ⃗ + b ) f_{\vec w,b}(\vec x)=g(\vec w\cdot\vec x+b) f w , b ( x ) = g ( w ⋅ x + b ) 这里的 z 是一个中间变量,g 是 Sigmoid 函数。
4. Sigmoid 函数
Sigmoid 函数定义为:
g ( z ) = 1 1 + e − z g(z)=\frac{1}{1+e^{-z}} g ( z ) = 1 + e − z 1 其中 e 是自然常数,约等于 2.71828。
Sigmoid 函数具有以下性质:
z 可以是任意实数
g(z) 的取值严格位于 0 和 1 之间
当 z=0 时,g(z)=0.5
当 z 很大时,g(z) 接近 1
当 z 很小时,g(z) 接近 0
因此逻辑回归的预测值可以解释为属于类别 1 的概率:
f_{\vec w,b}(\vec x)=P(y=1\mid\vec x;\vec w,b)
读作:给定输入 \vec x、参数 \vec w,b 时,标签 y=1 的概率。
5. Sigmoid 函数的数值示例
当 z=0 时:
g ( 0 ) = 1 1 + e 0 = 1 2 = 0.5 g(0)=\frac{1}{1+e^0}=\frac12=0.5 g ( 0 ) = 1 + e 0 1 = 2 1 = 0.5 当 z=2 时:
g ( 2 ) = 1 1 + e − 2 ≈ 0.8808 g(2)=\frac{1}{1+e^{-2}}\approx0.8808 g ( 2 ) = 1 + e − 2 1 ≈ 0.8808 模型认为样本属于类别 1 的概率约为 88.08%。
当 z=-2 时:
g ( − 2 ) = 1 1 + e 2 ≈ 0.1192 g(-2)=\frac{1}{1+e^2}\approx0.1192 g ( − 2 ) = 1 + e 2 1 ≈ 0.1192 模型认为样本属于类别 1 的概率约为 11.92%,因此更倾向于类别 0。
6. 从概率到类别
逻辑回归先输出概率,再使用阈值把概率转换为类别。
常用阈值是 0.5:
y ^ = { 1 , f w ⃗ , b ( x ⃗ ) ≥ 0.5 0 , f w ⃗ , b ( x ⃗ ) < 0.5 \hat y= \begin{cases} 1,&f_{\vec w,b}(\vec x)\geq0.5\\ 0,&f_{\vec w,b}(\vec x)<0.5 \end{cases} y ^ = { 1 , 0 , f w , b ( x ) ≥ 0.5 f w , b ( x ) < 0.5 因为:
g ( 0 ) = 0.5 g(0)=0.5 g ( 0 ) = 0.5 且 Sigmoid 函数是单调递增的,所以:
f w ⃗ , b ( x ⃗ ) ≥ 0.5 ⟺ z ≥ 0 f_{\vec w,b}(\vec x)\geq0.5 \Longleftrightarrow z\geq0 f w , b ( x ) ≥ 0.5 ⟺ z ≥ 0 因此也可以直接根据 z 判断:
y ^ = 1 当且仅当 w ⃗ ⋅ x ⃗ + b ≥ 0 \hat y=1\quad\text{当且仅当}\quad\vec w\cdot\vec x+b\geq0 y ^ = 1 当且仅当 w ⋅ x + b ≥ 0 7. 决策边界
决策边界(Decision Boundary)是模型从类别 0 切换到类别 1 的分界线,通常由以下方程定义:
w ⃗ ⋅ x ⃗ + b = 0 \vec w\cdot\vec x+b=0 w ⋅ x + b = 0 当只有两个特征时:
w 1 x 1 + w 2 x 2 + b = 0 w_1x_1+w_2x_2+b=0 w 1 x 1 + w 2 x 2 + b = 0 如果 w_2\neq0,可以写成:
x 2 = − w 1 x 1 + b w 2 x_2=-\frac{w_1x_1+b}{w_2} x 2 = − w 2 w 1 x 1 + b 这是一个二维平面上的直线。
需要区分:
Sigmoid 曲线描述 z 到概率的映射
决策边界描述输入空间中类别发生改变的位置
决策边界不一定是 Sigmoid 图像本身
8. 线性决策边界与非线性决策边界
如果 z 只是原始特征的线性组合:
z = w 1 x 1 + w 2 x 2 + b z=w_1x_1+w_2x_2+b z = w 1 x 1 + w 2 x 2 + b 决策边界是直线。
如果通过特征工程构造了平方特征:
z = w 1 x 1 2 + w 2 x 2 2 + b z=w_1x_1^2+w_2x_2^2+b z = w 1 x 1 2 + w 2 x 2 2 + b 令 z=0,可能得到圆形或其他曲线边界。
虽然决策边界对原始输入可能是曲线,但模型对参数 w,b 仍然可以是线性的。
9. 逻辑回归的 Python 示例
import numpy as np


def sigmoid(z):
    return 1 / (1 + np.exp(-z))


x = np.array([2.0, 3.0])
w = np.array([0.8, -0.4])
b = 0.1

z = w @ x + b
probability = sigmoid(z)
prediction = int(probability >= 0.5)

print(z)
print(probability)
print(prediction)
代码执行顺序是:
w @ x + b 计算 zsigmoid(z) 计算属于类别 1 的概率probability >= 0.5 根据阈值生成类别预测
Week 3 · Lesson 2:Cost function for logistic regression(逻辑回归的代价函数)
1. 为什么不能继续使用平方误差
线性回归中使用的平方误差是:
1 2 ( f w ⃗ , b ( x ⃗ ) − y ) 2 \frac12\left(f_{\vec w,b}(\vec x)-y\right)^2 2 1 ( f w , b ( x ) − y ) 2 如果把逻辑回归的 Sigmoid 输出直接代入平方误差,得到的代价函数通常不是凸函数,可能出现多个低点或复杂的曲面,使梯度下降难以稳定找到全局最小值。
因此,逻辑回归使用专门设计的损失函数:Logistic Loss,也叫对数损失或交叉熵损失。
2. 单个样本的逻辑损失
设模型输出:
f = f w ⃗ , b ( x ⃗ ) f=f_{\vec w,b}(\vec x) f = f w , b ( x ) 单个样本的损失函数为:
L ( f , y ) = − y log ( f ) − ( 1 − y ) log ( 1 − f ) L(f,y)=-y\log(f)-(1-y)\log(1-f) L ( f , y ) = − y log ( f ) − ( 1 − y ) log ( 1 − f ) 这里的 \log 是自然对数。
由于二分类标签只有 0 和 1,这个公式可以同时处理两种情况。
3. 当真实标签为 y=1
代入 y=1:
L ( f , 1 ) = − 1 log ( f ) − 0 log ( 1 − f ) L(f,1)=-1\log(f)-0\log(1-f) L ( f , 1 ) = − 1 log ( f ) − 0 log ( 1 − f ) 所以:
L ( f , 1 ) = − log ( f ) L(f,1)=-\log(f) L ( f , 1 ) = − log ( f ) 如果模型预测正确且很有信心,例如 f=0.99:
L ( 0.99 , 1 ) = − log ( 0.99 ) ≈ 0.0101 L(0.99,1)=-\log(0.99)\approx0.0101 L ( 0.99 , 1 ) = − log ( 0.99 ) ≈ 0.0101 损失很小。
如果模型预测错误且很有信心,例如 f=0.01:
L ( 0.01 , 1 ) = − log ( 0.01 ) ≈ 4.6052 L(0.01,1)=-\log(0.01)\approx4.6052 L ( 0.01 , 1 ) = − log ( 0.01 ) ≈ 4.6052 损失很大。
因此,当真实标签是 1 时,模型应该让 f 尽可能接近 1。
4. 当真实标签为 y=0
代入 y=0:
L ( f , 0 ) = − 0 log ( f ) − 1 log ( 1 − f ) L(f,0)=-0\log(f)-1\log(1-f) L ( f , 0 ) = − 0 log ( f ) − 1 log ( 1 − f ) 所以:
L ( f , 0 ) = − log ( 1 − f ) L(f,0)=-\log(1-f) L ( f , 0 ) = − log ( 1 − f ) 如果模型预测正确且很有信心,例如 f=0.01:
L ( 0.01 , 0 ) = − log ( 0.99 ) ≈ 0.0101 L(0.01,0)=-\log(0.99)\approx0.0101 L ( 0.01 , 0 ) = − log ( 0.99 ) ≈ 0.0101 损失很小。
如果模型预测错误且很有信心,例如 f=0.99:
L ( 0.99 , 0 ) = − log ( 0.01 ) ≈ 4.6052 L(0.99,0)=-\log(0.01)\approx4.6052 L ( 0.99 , 0 ) = − log ( 0.01 ) ≈ 4.6052 损失很大。
因此,当真实标签是 0 时,模型应该让 f 尽可能接近 0。
5. 统一损失公式的直观理解
L ( f , y ) = − y log ( f ) − ( 1 − y ) log ( 1 − f ) L(f,y)=-y\log(f)-(1-y)\log(1-f) L ( f , y ) = − y log ( f ) − ( 1 − y ) log ( 1 − f ) 当 y=1 时,第一项保留,第二项消失;当 y=0 时,第一项消失,第二项保留。
可以把它理解为:
真实标签为 1,就惩罚模型把 f 预测得太小
真实标签为 0,就惩罚模型把 f 预测得太大
错误越自信,惩罚越大
正确且越自信,损失越接近 0
6. 逻辑回归的代价函数
对 m 个训练样本的损失求平均,得到代价函数:
J ( w ⃗ , b ) = 1 m ∑ i = 1 m L ( f w ⃗ , b ( x ⃗ ( i ) ) , y ( i ) ) J(\vec w,b)=\frac{1}{m}\sum_{i=1}^{m}L\left(f_{\vec w,b}(\vec x^{(i)}),y^{(i)}\right) J ( w , b ) = m 1 i = 1 ∑ m L ( f w , b ( x ( i ) ) , y ( i ) ) 代入 Logistic Loss 后:
J ( w ⃗ , b ) = − 1 m ∑ i = 1 m [ y ( i ) log ( f w ⃗ , b ( x ⃗ ( i ) ) ) + ( 1 − y ( i ) ) log ( 1 − f w ⃗ , b ( x ⃗ ( i ) ) ) ] J(\vec w,b)=-\frac{1}{m}\sum_{i=1}^{m}\left[y^{(i)}\log\left(f_{\vec w,b}(\vec x^{(i)})\right)+(1-y^{(i)})\log\left(1-f_{\vec w,b}(\vec x^{(i)})\right)\right] J ( w , b ) = − m 1 i = 1 ∑ m [ y ( i ) log ( f w , b ( x ( i ) ) ) + ( 1 − y ( i ) ) log ( 1 − f w , b ( x ( i ) ) ) ] 这就是逻辑回归常用的交叉熵代价函数。
它与线性回归代价函数的主要区别是:
线性回归使用平方误差
逻辑回归使用对数损失
逻辑回归的预测值经过 Sigmoid 函数
逻辑回归代价函数前面通常是 \frac1m,没有必要加入 \frac12
7. 代价函数为什么能训练分类器
假设一个样本的真实标签是 y=1:
如果模型输出 f=0.9,损失较小
如果模型输出 f=0.5,损失为 -\log(0.5)\approx0.693
如果模型输出 f=0.1,损失较大
因此最小化代价函数会推动模型对正样本输出更大的概率。
对于真实标签为 0 的样本,最小化代价函数会推动模型输出更小的概率。
对所有样本取平均,就会得到一组能够较好区分两类样本的参数。
8. 概率、损失和代价的区别
概率 f_{\vec w,b}(\vec x):模型认为样本属于类别 1 的可能性
损失 L(f,y):模型对一个样本预测错误的惩罚
代价 J(\vec w,b):所有训练样本损失的平均值
三者的关系是:
\text{概率}\rightarrow\text{单样本损失}\rightarrow\text{平均代价}
9. 交叉熵的名称
这个代价函数也叫:
Logistic Loss
Log Loss
Binary Cross-Entropy
二元交叉熵
对数损失
它们在二分类逻辑回归的这个语境中通常指同一种损失形式。
10. 逻辑回归代价函数的 Python 实现
import numpy as np


def sigmoid(z):
    return 1 / (1 + np.exp(-z))


def compute_cost_logistic(X, y, w, b):
    m = X.shape[0]
    probabilities = sigmoid(X @ w + b)
    epsilon = 1e-15
    probabilities = np.clip(probabilities, epsilon, 1 - epsilon)
    loss = -y * np.log(probabilities)
    loss -= (1 - y) * np.log(1 - probabilities)
    return np.sum(loss) / m
clip 的作用是避免计算 \log(0)。数学上 Sigmoid 输出不会真正等于 0 或 1,但计算机浮点数可能出现下溢或舍入问题。
Week 3 · Lesson 3:Gradient descent for logistic regression(逻辑回归的梯度下降)
1. 逻辑回归的训练目标
逻辑回归训练的目标仍然是找到一组参数,使代价函数最小:
min w ⃗ , b J ( w ⃗ , b ) \min_{\vec w,b}J(\vec w,b) w , b min J ( w , b ) 但这里的模型和代价函数已经换成:
f w ⃗ , b ( x ⃗ ) = g ( w ⃗ ⋅ x ⃗ + b ) f_{\vec w,b}(\vec x)=g(\vec w\cdot\vec x+b) f w , b ( x ) = g ( w ⋅ x + b ) J ( w ⃗ , b ) = − 1 m ∑ i = 1 m [ y ( i ) log ( f ( i ) ) + ( 1 − y ( i ) ) log ( 1 − f ( i ) ) ] J(\vec w,b)=-\frac{1}{m}\sum_{i=1}^{m}\left[y^{(i)}\log(f^{(i)})+(1-y^{(i)})\log(1-f^{(i)})\right] J ( w , b ) = − m 1 i = 1 ∑ m [ y ( i ) log ( f ( i ) ) + ( 1 − y ( i ) ) log ( 1 − f ( i ) ) ] 其中:
f ( i ) = f w ⃗ , b ( x ⃗ ( i ) ) f^{(i)}=f_{\vec w,b}(\vec x^{(i)}) f ( i ) = f w , b ( x ( i ) ) 2. 参数更新公式
逻辑回归仍然使用梯度下降:
w j : = w j − α ∂ J ( w ⃗ , b ) ∂ w j w_j:=w_j-\alpha\frac{\partial J(\vec w,b)}{\partial w_j} w j := w j − α ∂ w j ∂ J ( w , b ) b : = b − α ∂ J ( w ⃗ , b ) ∂ b b:=b-\alpha\frac{\partial J(\vec w,b)}{\partial b} b := b − α ∂ b ∂ J ( w , b ) 其中 j=1,2,\ldots,n。
关键是先计算每个参数方向上的梯度,再沿梯度的反方向更新参数。
3. 逻辑回归的梯度公式
逻辑回归的梯度为:
∂ J ( w ⃗ , b ) ∂ w j = 1 m ∑ i = 1 m ( f w ⃗ , b ( x ⃗ ( i ) ) − y ( i ) ) x j ( i ) \frac{\partial J(\vec w,b)}{\partial w_j}=\frac{1}{m}\sum_{i=1}^{m}\left(f_{\vec w,b}(\vec x^{(i)})-y^{(i)}\right)x_j^{(i)} ∂ w j ∂ J ( w , b ) = m 1 i = 1 ∑ m ( f w , b ( x ( i ) ) − y ( i ) ) x j ( i ) ∂ J ( w ⃗ , b ) ∂ b = 1 m ∑ i = 1 m ( f w ⃗ , b ( x ⃗ ( i ) ) − y ( i ) ) \frac{\partial J(\vec w,b)}{\partial b}=\frac{1}{m}\sum_{i=1}^{m}\left(f_{\vec w,b}(\vec x^{(i)})-y^{(i)}\right) ∂ b ∂ J ( w , b ) = m 1 i = 1 ∑ m ( f w , b ( x ( i ) ) − y ( i ) ) 形式上,它们和多元线性回归的梯度很像,但不能因此认为两种算法完全相同。
二者的关键区别是:
线性回归的 f=\vec w\cdot\vec x+b
逻辑回归的 f=g(\vec w\cdot\vec x+b)
线性回归使用平方误差代价
逻辑回归使用交叉熵代价
4. 梯度公式的详细推导
对单个样本,定义:
z = w ⃗ ⋅ x ⃗ + b z=\vec w\cdot\vec x+b z = w ⋅ x + b a = g ( z ) = 1 1 + e − z a=g(z)=\frac{1}{1+e^{-z}} a = g ( z ) = 1 + e − z 1 其中 a 就是模型输出的概率。
单个样本的损失为:
L ( a , y ) = − y log ( a ) − ( 1 − y ) log ( 1 − a ) L(a,y)=-y\log(a)-(1-y)\log(1-a) L ( a , y ) = − y log ( a ) − ( 1 − y ) log ( 1 − a ) 4.1 Sigmoid 的导数
Sigmoid 的导数有一个非常重要的结果:
g ′ ( z ) = g ( z ) ( 1 − g ( z ) ) g'(z)=g(z)(1-g(z)) g ′ ( z ) = g ( z ) ( 1 − g ( z )) 因为 a=g(z),所以也可以写成:
d a d z = a ( 1 − a ) \frac{\mathrm da}{\mathrm dz}=a(1-a) d z d a = a ( 1 − a ) 4.2 损失对概率的偏导
对 a 求偏导:
∂ L ∂ a = − y a + 1 − y 1 − a \frac{\partial L}{\partial a}=-\frac{y}{a}+\frac{1-y}{1-a} ∂ a ∂ L = − a y + 1 − a 1 − y 第二项的正号来自:
d d a [ − ( 1 − y ) log ( 1 − a ) ] = 1 − y 1 − a \frac{\mathrm d}{\mathrm da}\left[-(1-y)\log(1-a)\right]=\frac{1-y}{1-a} d a d [ − ( 1 − y ) log ( 1 − a ) ] = 1 − a 1 − y 4.3 使用链式法则
根据链式法则:
∂ L ∂ z = ∂ L ∂ a d a d z \frac{\partial L}{\partial z}=\frac{\partial L}{\partial a}\frac{\mathrm da}{\mathrm dz} ∂ z ∂ L = ∂ a ∂ L d z d a 代入前面的两个结果:
∂ L ∂ z = [ − y a + 1 − y 1 − a ] a ( 1 − a ) \frac{\partial L}{\partial z}=\left[-\frac{y}{a}+\frac{1-y}{1-a}\right]a(1-a) ∂ z ∂ L = [ − a y + 1 − a 1 − y ] a ( 1 − a ) 展开并化简:
∂ L ∂ z = a − y \frac{\partial L}{\partial z}=a-y ∂ z ∂ L = a − y 这是逻辑回归梯度推导中最关键的简化结果。
4.4 对 w_j 求偏导
因为:
z = ∑ j = 1 n w j x j + b z=\sum_{j=1}^{n}w_jx_j+b z = j = 1 ∑ n w j x j + b 所以:
∂ z ∂ w j = x j \frac{\partial z}{\partial w_j}=x_j ∂ w j ∂ z = x j 再次使用链式法则:
∂ L ∂ w j = ∂ L ∂ z ∂ z ∂ w j \frac{\partial L}{\partial w_j}=\frac{\partial L}{\partial z}\frac{\partial z}{\partial w_j} ∂ w j ∂ L = ∂ z ∂ L ∂ w j ∂ z 得到:
∂ L ∂ w j = ( a − y ) x j \frac{\partial L}{\partial w_j}=(a-y)x_j ∂ w j ∂ L = ( a − y ) x j 对所有样本取平均:
∂ J ∂ w j = 1 m ∑ i = 1 m ( a ( i ) − y ( i ) ) x j ( i ) \frac{\partial J}{\partial w_j}=\frac{1}{m}\sum_{i=1}^{m}(a^{(i)}-y^{(i)})x_j^{(i)} ∂ w j ∂ J = m 1 i = 1 ∑ m ( a ( i ) − y ( i ) ) x j ( i ) 将 a^{(i)} 换回模型输出 f_{\vec w,b}(\vec x^{(i)}),就是逻辑回归的梯度公式。
4.5 对 b 求偏导
因为:
∂ z ∂ b = 1 \frac{\partial z}{\partial b}=1 ∂ b ∂ z = 1 所以:
∂ L ∂ b = ∂ L ∂ z ∂ z ∂ b = a − y \frac{\partial L}{\partial b}=\frac{\partial L}{\partial z}\frac{\partial z}{\partial b}=a-y ∂ b ∂ L = ∂ z ∂ L ∂ b ∂ z = a − y 对所有样本取平均:
∂ J ∂ b = 1 m ∑ i = 1 m ( a ( i ) − y ( i ) ) \frac{\partial J}{\partial b}=\frac{1}{m}\sum_{i=1}^{m}(a^{(i)}-y^{(i)}) ∂ b ∂ J = m 1 i = 1 ∑ m ( a ( i ) − y ( i ) ) 5. 为什么逻辑回归梯度看起来和线性回归一样
逻辑回归的梯度最终也包含:
( 预测值 − 真实值 ) × 特征 (\text{预测值}-\text{真实值})\times\text{特征} ( 预测值 − 真实值 ) × 特征 这是因为:
Sigmoid 的导数是 a(1-a)
交叉熵损失对概率求导后,与 Sigmoid 导数相乘
两部分恰好化简为 a-y
因此公式外观相似,但推导过程、模型输出和损失函数都不同。
6. 向量化梯度公式
将全部样本组成矩阵 X,预测概率向量为:
a ⃗ = sigmoid ( X w ⃗ + b ) \vec a=\operatorname{sigmoid}(X\vec w+b) a = sigmoid ( X w + b ) 误差向量为:
e ⃗ = a ⃗ − y ⃗ \vec e=\vec a-\vec y e = a − y 梯度为:
∇ w ⃗ J = 1 m X T ( a ⃗ − y ⃗ ) \nabla_{\vec w}J=\frac{1}{m}X^T(\vec a-\vec y) ∇ w J = m 1 X T ( a − y ) ∂ J ∂ b = 1 m ∑ i = 1 m ( a ( i ) − y ( i ) ) \frac{\partial J}{\partial b}=\frac{1}{m}\sum_{i=1}^{m}(a^{(i)}-y^{(i)}) ∂ b ∂ J = m 1 i = 1 ∑ m ( a ( i ) − y ( i ) ) 参数更新为:
w ⃗ : = w ⃗ − α 1 m X T ( a ⃗ − y ⃗ ) \vec w:=\vec w-\alpha\frac{1}{m}X^T(\vec a-\vec y) w := w − α m 1 X T ( a − y ) b : = b − α 1 m ∑ i = 1 m ( a ( i ) − y ( i ) ) b:=b-\alpha\frac{1}{m}\sum_{i=1}^{m}(a^{(i)}-y^{(i)}) b := b − α m 1 i = 1 ∑ m ( a ( i ) − y ( i ) ) 7. 逻辑回归梯度下降伪代码
import numpy as np


def sigmoid(z):
    return 1 / (1 + np.exp(-z))


def gradient_descent_logistic(X, y, w, b, alpha, num_iters):
    m = X.shape[0]
    cost_history = []

    for _ in range(num_iters):
        probabilities = sigmoid(X @ w + b)
        errors = probabilities - y
        dj_dw = (X.T @ errors) / m
        dj_db = np.sum(errors) / m
        w = w - alpha * dj_dw
        b = b - alpha * dj_db

        clipped = np.clip(probabilities, 1e-15, 1 - 1e-15)
        cost = -np.mean(
            y * np.log(clipped)
            + (1 - y) * np.log(1 - clipped)
        )
        cost_history.append(cost)

    return w, b, cost_history
8. 一次梯度更新的含义
对第 i 个样本:
a^{(i)}-y^{(i)}>0:模型把类别 1 的概率估计得偏高
a^{(i)}-y^{(i)}<0:模型把类别 1 的概率估计得偏低
a^{(i)}-y^{(i)} 越大,模型需要修正的方向越明显
对 w_j 来说,还要乘以 x_j^{(i)}:
特征值较大时,该样本对 w_j 梯度的影响可能较大
特征值为 0 时,该样本不会通过这个特征直接影响 w_j
正负特征值会影响参数更新方向
9. 逻辑回归训练过程
初始化 \vec w,b
计算每个样本的 z^{(i)}=\vec w\cdot\vec x^{(i)}+b
通过 Sigmoid 得到概率 a^{(i)}
计算概率误差 a^{(i)}-y^{(i)}
计算所有参数的平均梯度
同步更新 \vec w,b
记录代价函数
重复执行直到收敛或达到最大迭代次数
10. 逻辑回归中的学习率
学习率 \alpha 的含义与线性回归相同:
太小:代价下降很慢
太大:代价可能震荡或发散
合适:代价总体下降并趋于稳定
特征缩放对于逻辑回归也很重要,尤其当特征数值范围差异很大时。
Week 3 · Lesson 4:The problem of overfitting(过拟合问题)
1. 什么是过拟合
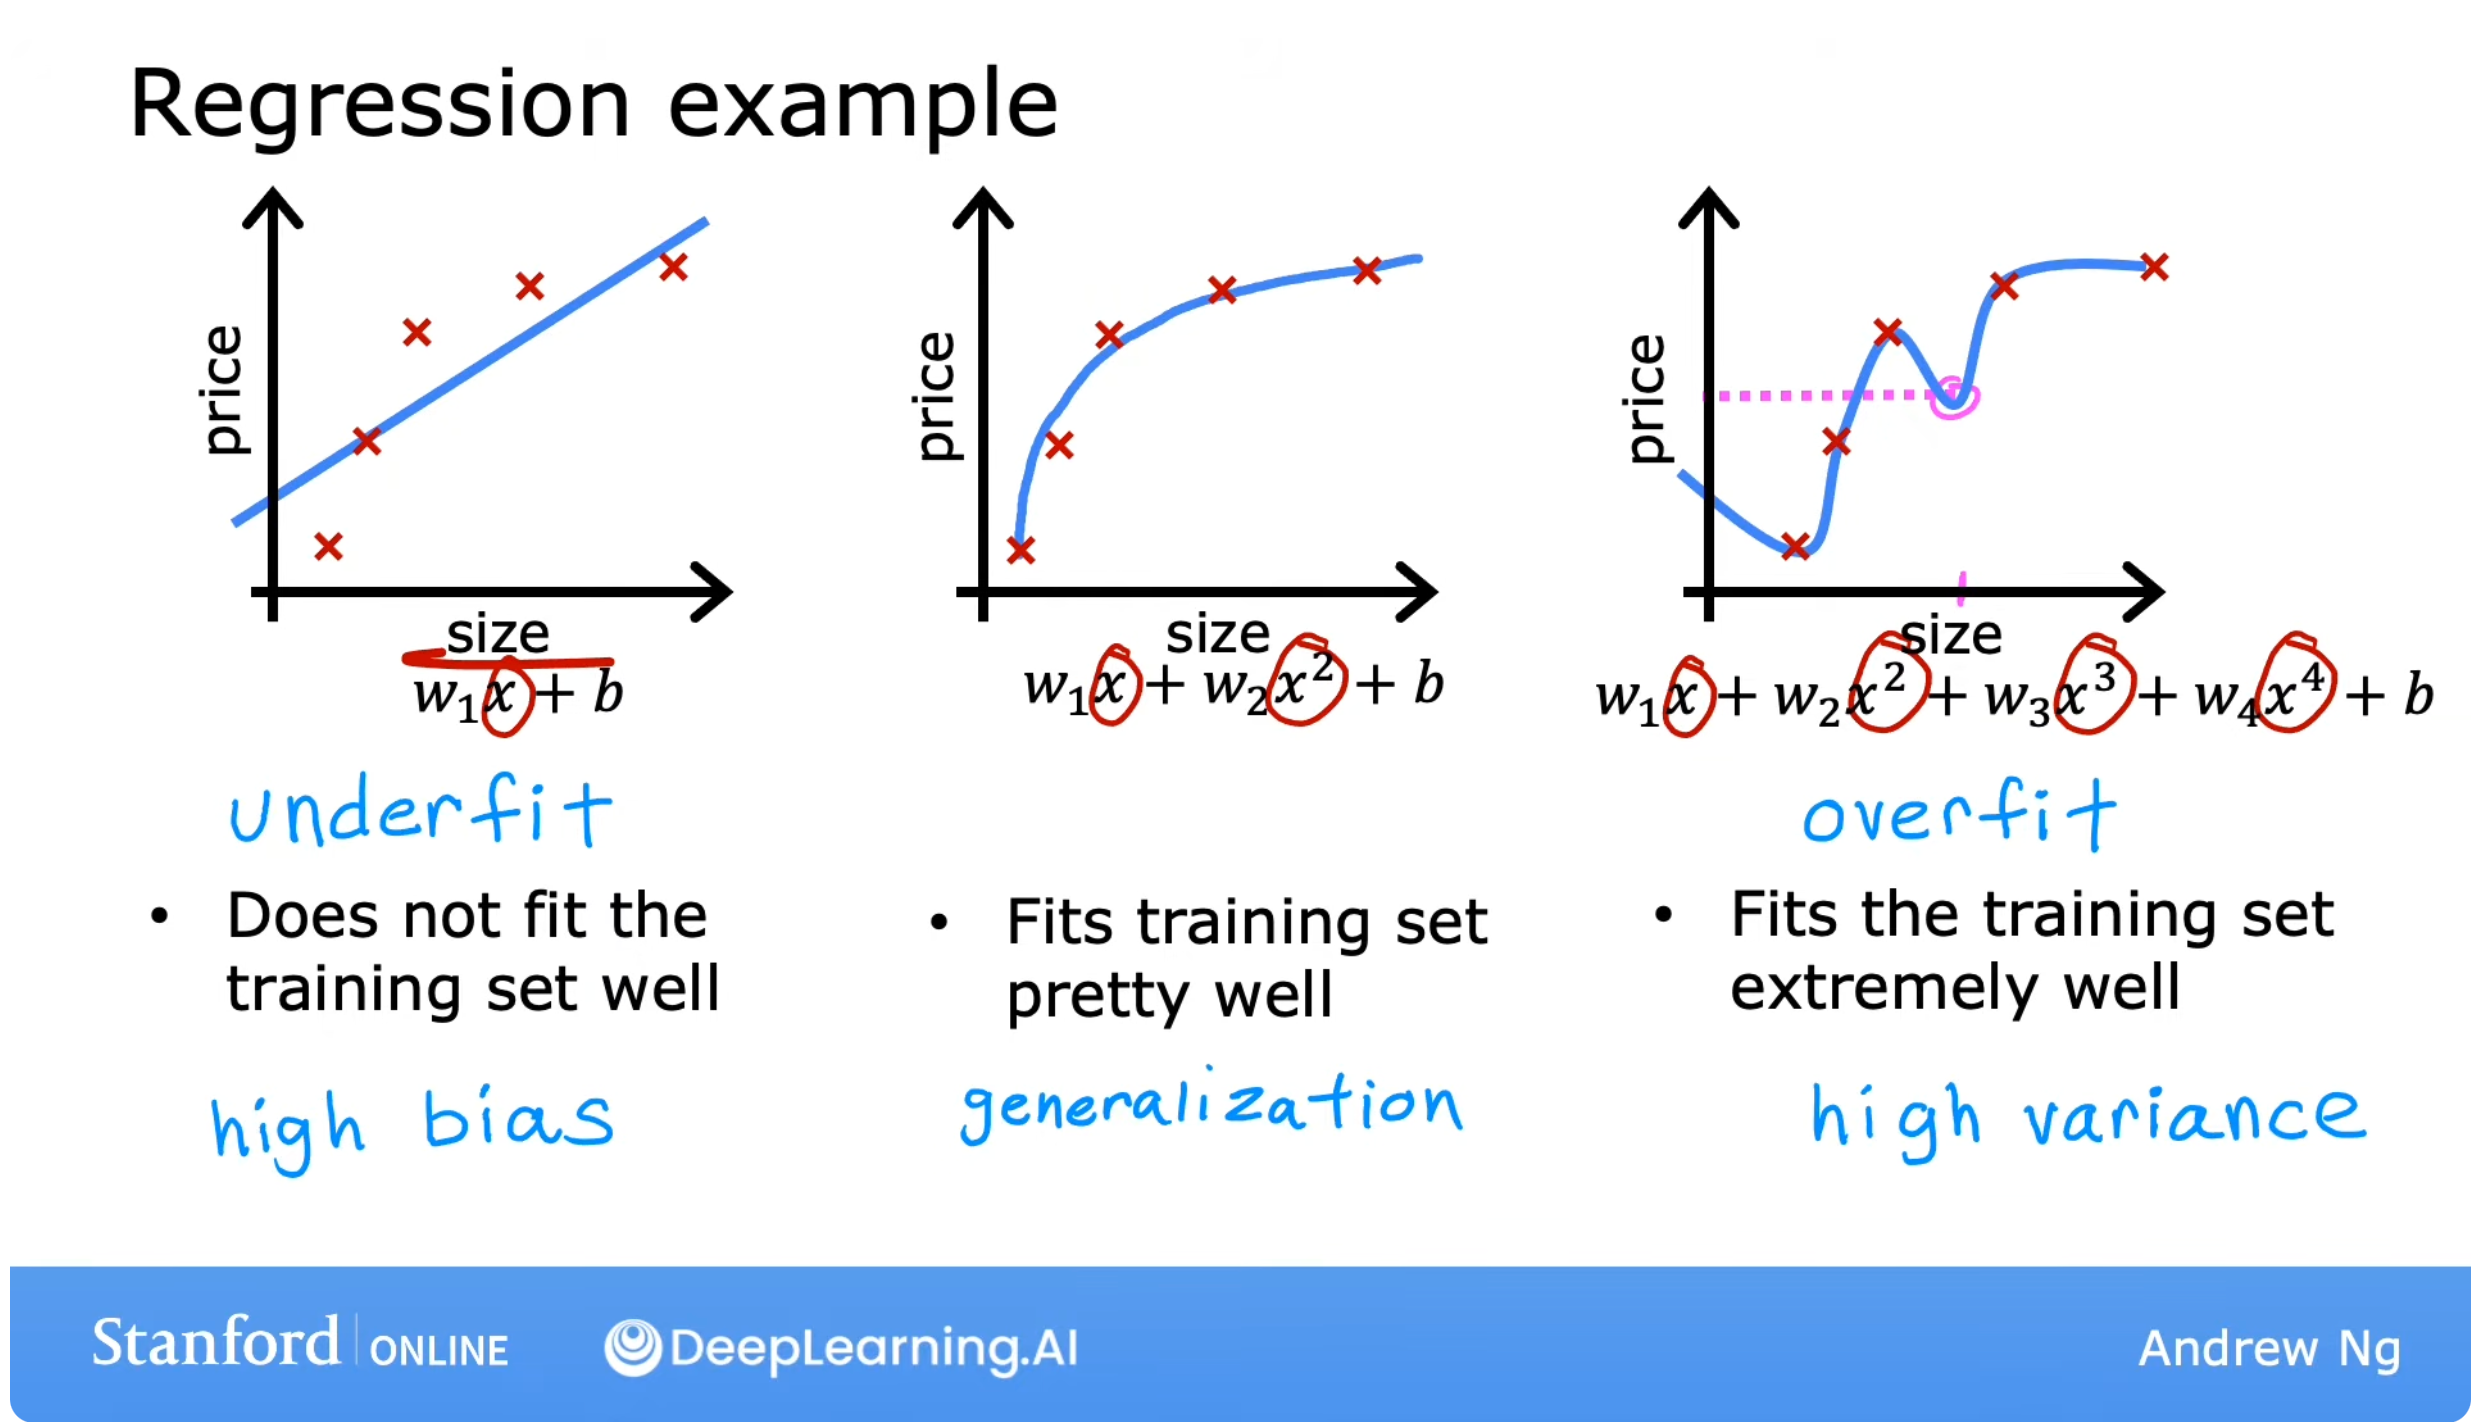
过拟合(Overfitting)是指模型过度适应训练数据中的细节,甚至把噪声也当成了规律。
过拟合模型在训练集上表现很好,但在没有见过的新数据上表现较差。
机器学习真正关心的是泛化(Generalization):
在新数据上的表现 \text{在新数据上的表现} 在新数据上的表现 而不是只记住训练集。
2. 欠拟合、恰当拟合和过拟合
2.1 欠拟合
欠拟合(Underfitting)也叫高偏差(High Bias):
模型过于简单
无法捕捉数据中的主要规律
训练集表现就不好
新数据表现通常也不好
2.2 恰当拟合
模型复杂度适中:
能够学习主要规律
不会过度追随噪声
训练集和验证集表现都较好
2.3 过拟合
过拟合也常与高方差(High Variance)相关:
模型过于复杂
训练集表现非常好
验证集或测试集表现明显变差
对训练数据中的小变化很敏感
3. 模型复杂度示例
使用一个特征 x 时:
f w ⃗ , b ( x ) = w 1 x + b f_{\vec w,b}(x)=w_1x+b f w , b ( x ) = w 1 x + b 模型较简单,可能欠拟合。
加入多项式特征后:
f w ⃗ , b ( x ) = w 1 x + w 2 x 2 + w 3 x 3 + b f_{\vec w,b}(x)=w_1x+w_2x^2+w_3x^3+b f w , b ( x ) = w 1 x + w 2 x 2 + w 3 x 3 + b 模型表达能力增强。
如果继续加入很多高次项:
f w ⃗ , b ( x ) = w 1 x + w 2 x 2 + ⋯ + w 100 x 100 + b f_{\vec w,b}(x)=w_1x+w_2x^2+\cdots+w_{100}x^{100}+b f w , b ( x ) = w 1 x + w 2 x 2 + ⋯ + w 100 x 100 + b 模型可能变得过于复杂,容易过拟合。
4. 处理过拟合的三种思路
常见方法有:
收集更多训练数据
减少或重新选择特征
使用正则化(Regularization)
如果训练数据不足,复杂模型很容易记住少量样本;更多数据可以帮助模型识别真正规律。
减少特征可以降低模型复杂度,但可能丢失有用信息。正则化则是在保留特征的同时,限制参数不要变得过大。
Week 3 · Lesson 5:Regularization(正则化)
1. 正则化的核心思想
正则化是在原来的代价函数后面增加一个参数惩罚项:
新的代价 = 原来的代价 + 复杂度惩罚 \text{新的代价}=\text{原来的代价}+\text{复杂度惩罚} 新的代价 = 原来的代价 + 复杂度惩罚 模型不仅要拟合训练数据,还要避免使用过大的参数。
对于线性模型,参数越大,通常意味着模型对特征变化越敏感,模型可能更复杂。
2. 为什么正则化可以缓解过拟合
假设模型中包含高次项:
f ( x ) = w 1 x + w 2 x 2 + w 3 x 3 + b f(x)=w_1x+w_2x^2+w_3x^3+b f ( x ) = w 1 x + w 2 x 2 + w 3 x 3 + b 如果 w_2,w_3 很大,模型可能会产生剧烈弯曲。
正则化会惩罚较大的权重,使这些权重倾向于变小,模型曲线更加平滑。
需要注意:正则化并不是强制把权重变成 0,而是让它们更小。
3. 正则化线性回归的代价函数
线性回归原来的代价函数为:
J ( w ⃗ , b ) = 1 2 m ∑ i = 1 m ( f w ⃗ , b ( x ⃗ ( i ) ) − y ( i ) ) 2 J(\vec w,b)=\frac{1}{2m}\sum_{i=1}^{m}\left(f_{\vec w,b}(\vec x^{(i)})-y^{(i)}\right)^2 J ( w , b ) = 2 m 1 i = 1 ∑ m ( f w , b ( x ( i ) ) − y ( i ) ) 2 加入 L2 正则化后:
J r e g ( w ⃗ , b ) = 1 2 m ∑ i = 1 m ( f w ⃗ , b ( x ⃗ ( i ) ) − y ( i ) ) 2 + λ 2 m ∑ j = 1 n w j 2 J_{\mathrm{reg}}(\vec w,b)=\frac{1}{2m}\sum_{i=1}^{m}\left(f_{\vec w,b}(\vec x^{(i)})-y^{(i)}\right)^2+\frac{\lambda}{2m}\sum_{j=1}^{n}w_j^2 J reg ( w , b ) = 2 m 1 i = 1 ∑ m ( f w , b ( x ( i ) ) − y ( i ) ) 2 + 2 m λ j = 1 ∑ n w j 2 其中:
\lambda:正则化参数,也叫惩罚系数
w_j^2:第 j 个权重的平方
求和从 j=1 到 n,不包含偏置 b
正则化后的目标是:
\min_{\vec w,b}J_{\mathrm{reg}}(\vec w,b)
4. 为什么通常不惩罚 b
偏置 b 负责整体平移模型,不对应某一个具体特征的影响强度。
因此课程中通常只惩罚 w_1,\ldots,w_n,不惩罚 b:
∑ j = 1 n w j 2 \sum_{j=1}^{n}w_j^2 j = 1 ∑ n w j 2 而不是:
b 2 + ∑ j = 1 n w j 2 b^2+\sum_{j=1}^{n}w_j^2 b 2 + j = 1 ∑ n w j 2 在特征数量很大时,是否把 b 纳入正则化对结果影响通常较小,但标准实现一般排除 b。
5. 正则化线性回归的梯度
对 w_j 求偏导:
∂ J r e g ∂ w j = 1 m ∑ i = 1 m ( f w ⃗ , b ( x ⃗ ( i ) ) − y ( i ) ) x j ( i ) + λ m w j \frac{\partial J_{\mathrm{reg}}}{\partial w_j}=\frac{1}{m}\sum_{i=1}^{m}\left(f_{\vec w,b}(\vec x^{(i)})-y^{(i)}\right)x_j^{(i)}+\frac{\lambda}{m}w_j ∂ w j ∂ J reg = m 1 i = 1 ∑ m ( f w , b ( x ( i ) ) − y ( i ) ) x j ( i ) + m λ w j 对 b 求偏导:
∂ J r e g ∂ b = 1 m ∑ i = 1 m ( f w ⃗ , b ( x ⃗ ( i ) ) − y ( i ) ) \frac{\partial J_{\mathrm{reg}}}{\partial b}=\frac{1}{m}\sum_{i=1}^{m}\left(f_{\vec w,b}(\vec x^{(i)})-y^{(i)}\right) ∂ b ∂ J reg = m 1 i = 1 ∑ m ( f w , b ( x ( i ) ) − y ( i ) ) 正则化项对 w_j 的导数是:
∂ ∂ w j ( λ 2 m w j 2 ) = λ m w j \frac{\partial}{\partial w_j}\left(\frac{\lambda}{2m}w_j^2\right)=\frac{\lambda}{m}w_j ∂ w j ∂ ( 2 m λ w j 2 ) = m λ w j 6. 正则化线性回归的更新公式
w j : = w j − α [ 1 m ∑ i = 1 m ( f w ⃗ , b ( x ⃗ ( i ) ) − y ( i ) ) x j ( i ) + λ m w j ] w_j:=w_j-\alpha\left[\frac{1}{m}\sum_{i=1}^{m}\left(f_{\vec w,b}(\vec x^{(i)})-y^{(i)}\right)x_j^{(i)}+\frac{\lambda}{m}w_j\right] w j := w j − α [ m 1 i = 1 ∑ m ( f w , b ( x ( i ) ) − y ( i ) ) x j ( i ) + m λ w j ] 整理正则化项后:
w j : = ( 1 − α λ m ) w j − α 1 m ∑ i = 1 m ( f w ⃗ , b ( x ⃗ ( i ) ) − y ( i ) ) x j ( i ) w_j:=\left(1-\alpha\frac{\lambda}{m}\right)w_j-\alpha\frac{1}{m}\sum_{i=1}^{m}\left(f_{\vec w,b}(\vec x^{(i)})-y^{(i)}\right)x_j^{(i)} w j := ( 1 − α m λ ) w j − α m 1 i = 1 ∑ m ( f w , b ( x ( i ) ) − y ( i ) ) x j ( i ) 这个式子说明,每次更新时,w_j 会先受到一个小于 1 的缩小因子影响,然后再接受数据误差带来的调整。
b 的更新不包含正则化项:
b : = b − α ∂ J r e g ∂ b b:=b-\alpha\frac{\partial J_{\mathrm{reg}}}{\partial b} b := b − α ∂ b ∂ J reg 7. 正则化逻辑回归的代价函数
逻辑回归原来的代价函数为:
J ( w ⃗ , b ) = − 1 m ∑ i = 1 m [ y ( i ) log ( f ( i ) ) + ( 1 − y ( i ) ) log ( 1 − f ( i ) ) ] J(\vec w,b)=-\frac{1}{m}\sum_{i=1}^{m}\left[y^{(i)}\log\left(f^{(i)}\right)+(1-y^{(i)})\log\left(1-f^{(i)}\right)\right] J ( w , b ) = − m 1 i = 1 ∑ m [ y ( i ) log ( f ( i ) ) + ( 1 − y ( i ) ) log ( 1 − f ( i ) ) ] 加入 L2 正则化后:
J r e g ( w ⃗ , b ) = − 1 m ∑ i = 1 m [ y ( i ) log ( f ( i ) ) + ( 1 − y ( i ) ) log ( 1 − f ( i ) ) ] + λ 2 m ∑ j = 1 n w j 2 J_{\mathrm{reg}}(\vec w,b)=-\frac{1}{m}\sum_{i=1}^{m}\left[y^{(i)}\log\left(f^{(i)}\right)+(1-y^{(i)})\log\left(1-f^{(i)}\right)\right]+\frac{\lambda}{2m}\sum_{j=1}^{n}w_j^2 J reg ( w , b ) = − m 1 i = 1 ∑ m [ y ( i ) log ( f ( i ) ) + ( 1 − y ( i ) ) log ( 1 − f ( i ) ) ] + 2 m λ j = 1 ∑ n w j 2 这里:
第一部分衡量分类预测错误
第二部分惩罚过大的权重
b 通常不参与正则化
8. 正则化逻辑回归的梯度
对 w_j 求偏导:
∂ J r e g ∂ w j = 1 m ∑ i = 1 m ( f ( i ) − y ( i ) ) x j ( i ) + λ m w j \frac{\partial J_{\mathrm{reg}}}{\partial w_j}=\frac{1}{m}\sum_{i=1}^{m}\left(f^{(i)}-y^{(i)}\right)x_j^{(i)}+\frac{\lambda}{m}w_j ∂ w j ∂ J reg = m 1 i = 1 ∑ m ( f ( i ) − y ( i ) ) x j ( i ) + m λ w j 对 b 求偏导:
∂ J r e g ∂ b = 1 m ∑ i = 1 m ( f ( i ) − y ( i ) ) \frac{\partial J_{\mathrm{reg}}}{\partial b}=\frac{1}{m}\sum_{i=1}^{m}\left(f^{(i)}-y^{(i)}\right) ∂ b ∂ J reg = m 1 i = 1 ∑ m ( f ( i ) − y ( i ) ) 逻辑回归的模型输出仍然是:
f ( i ) = g ( w ⃗ ⋅ x ⃗ ( i ) + b ) f^{(i)}=g(\vec w\cdot\vec x^{(i)}+b) f ( i ) = g ( w ⋅ x ( i ) + b ) 9. 正则化参数 \lambda
\lambda 决定“拟合数据”和“保持模型简单”之间的平衡:
\lambda=0:没有正则化,模型只优化训练误差
\lambda 太小:正则化作用弱,仍然可能过拟合
\lambda 太大:参数被压得过小,模型可能欠拟合
合适的 \lambda:模型在新数据上的泛化表现较好
正则化强度不是越大越好,需要使用验证集或交叉验证选择。
10. 不同 \lambda 下的模型直观变化
当 \lambda 较小时:
模型允许权重较大
决策边界可以更复杂
可能更贴合训练数据
当 \lambda 较大时:
权重整体趋向较小
决策边界趋向更平滑、简单
过拟合风险降低
过大时可能无法区分训练数据
11. 正则化参数的选择
不能根据训练集代价最小来选择 \lambda,因为更小的训练误差不一定带来更好的泛化能力。
一般做法是:
选择一组候选值
使用训练集训练每个模型
使用验证集计算验证误差
选择验证集表现较好的 \lambda
最后在测试集上进行一次最终评估
候选值可以按数量级尝试:
0,\quad0.001,\quad0.01,\quad0.1,\quad1,\quad10,\quad100
12. 特征缩放与正则化
正则化直接惩罚权重大小,因此特征尺度会影响惩罚效果。
如果一个特征数值很大,模型可能只需要很小的权重;另一个特征数值很小,模型可能需要较大的权重。
在没有缩放的情况下,直接比较权重大小并不公平,也会使正则化对不同特征产生不均衡影响。
因此,在使用正则化前通常应先进行特征缩放。
13. 逻辑回归过拟合的完整处理流程
观察训练集与验证集的损失或分类指标
判断模型是欠拟合还是过拟合
检查是否加入了过多或不合理的高阶特征
尝试减少特征或收集更多数据
进行特征缩放
尝试不同的正则化参数 \lambda
选择验证集表现较好的模型
在测试集上进行最终评估
Week 3 总结
分类 → Sigmoid → 逻辑回归代价函数 → 梯度下降 → 正则化 \text{分类}\rightarrow\text{Sigmoid}\rightarrow\text{逻辑回归代价函数}\rightarrow\text{梯度下降}\rightarrow\text{正则化} 分类 → Sigmoid → 逻辑回归代价函数 → 梯度下降 → 正则化 逻辑回归先计算线性组合 z=\vec w\cdot\vec x+b,再通过 Sigmoid 把它转换成类别 1 的概率。交叉熵代价函数根据预测概率和真实标签计算损失,梯度下降不断调整 \vec w,b,正则化用于限制模型复杂度并缓解过拟合。
Week 3 最容易混淆的公式
模型的线性部分:
z = w ⃗ ⋅ x ⃗ + b z=\vec w\cdot\vec x+b z = w ⋅ x + b Sigmoid 函数:
g ( z ) = 1 1 + e − z g(z)=\frac{1}{1+e^{-z}} g ( z ) = 1 + e − z 1 逻辑回归预测:
f w ⃗ , b ( x ⃗ ) = g ( w ⃗ ⋅ x ⃗ + b ) f_{\vec w,b}(\vec x)=g(\vec w\cdot\vec x+b) f w , b ( x ) = g ( w ⋅ x + b ) 单样本损失:
L ( f , y ) = − y log ( f ) − ( 1 − y ) log ( 1 − f ) L(f,y)=-y\log(f)-(1-y)\log(1-f) L ( f , y ) = − y log ( f ) − ( 1 − y ) log ( 1 − f ) 总体代价:
J ( w ⃗ , b ) = 1 m ∑ i = 1 m L ( f ( i ) , y ( i ) ) J(\vec w,b)=\frac{1}{m}\sum_{i=1}^{m}L\left(f^{(i)},y^{(i)}\right) J ( w , b ) = m 1 i = 1 ∑ m L ( f ( i ) , y ( i ) ) 梯度:
∂ J ∂ w j = 1 m ∑ i = 1 m ( f ( i ) − y ( i ) ) x j ( i ) \frac{\partial J}{\partial w_j}=\frac{1}{m}\sum_{i=1}^{m}\left(f^{(i)}-y^{(i)}\right)x_j^{(i)} ∂ w j ∂ J = m 1 i = 1 ∑ m ( f ( i ) − y ( i ) ) x j ( i ) ∂ J ∂ b = 1 m ∑ i = 1 m ( f ( i ) − y ( i ) ) \frac{\partial J}{\partial b}=\frac{1}{m}\sum_{i=1}^{m}\left(f^{(i)}-y^{(i)}\right) ∂ b ∂ J = m 1 i = 1 ∑ m ( f ( i ) − y ( i ) ) 正则化项:
λ 2 m ∑ j = 1 n w j 2 \frac{\lambda}{2m}\sum_{j=1}^{n}w_j^2 2 m λ j = 1 ∑ n w j 2 把这些公式串起来,就是:
输入特征 → z → 概率 f → 损失 L → 代价 J → 梯度 → 更新参数 \text{输入特征}\rightarrow z\rightarrow\text{概率 }f\rightarrow\text{损失 }L\rightarrow\text{代价 }J\rightarrow\text{梯度}\rightarrow\text{更新参数} 输入特征 → z → 概率 f → 损失 L → 代价 J → 梯度 → 更新参数