hello Agent
从智能体定义、语言模型和 Agent 范式,到记忆、检索、协议、训练与评估的系统学习笔记。
一、智能体
1、什么是智能体
智能体,英文是 Agent,可以理解为: 能够感知环境、进行决策,并采取行动完成目标的系统 智能体通常包含四个要素:
| 要素 | 含义 |
|---|---|
| 环境 | 智能体所在的外部世界 |
| 传感器 | 获取信息的方式 |
| 执行器 | 执行动作的方式 |
| 自主性 | 能根据目标自行决策 |
智能体不是只会被动回答问题的程序,而是能够根据环境变化主动行动的系统
2、智能体的主要类型
传统智能体可以分为几类:
| 类型 | 特点 |
|---|---|
| 简单反射智能体 | 根据固定规则快速反应 |
| 基于模型的智能体 | 有内部状态,能记住部分环境信息 |
| 基于目标的智能体 | 根据目标选择行动 |
| 基于效用的智能体 | 在多个方案中选择最优方案 |
| 学习型智能体 | 能通过经验不断改进 |
例如,导航系统就是一个基于目标和效用的智能体:它不仅要到达目的地,还会综合考虑距离、时间、拥堵情况等因素
3、LLM 驱动的智能体
大语言模型出现后,智能体进入了新的阶段。 传统智能体依赖人工设计规则,而 LLM 智能体可以直接理解自然语言任务,并进行推理、规划和工具调用。
例如用户输入:
帮我规划一次旅行LLM 智能体可能会自动拆解为:
理解需求 → 查询天气 → 搜索景点 → 制定路线 → 输出行程所以,LLM 智能体更像是一个会思考、会规划、会调用工具的助手。
4、PEAS 模型
PEAS 是描述智能体任务环境的方法:
| 缩写 | 含义 |
|---|---|
| P | Performance,性能指标 |
| E | Environment,环境 |
| A | Actuators,执行器 |
| S | Sensors,传感器 |
例如旅行智能体:
| PEAS | 示例 |
|---|---|
| 性能指标 | 行程合理、预算合适、用户满意 |
| 环境 | 天气、交通、酒店、景点 |
| 执行器 | 查询 API、搜索网页、生成方案 |
| 传感器 | 用户输入、搜索结果、工具反馈 |
PEAS 的作用是帮助我们明确:智能体要完成什么任务、面对什么环境、能做什么动作。
5、Agent Loop
智能体的核心运行方式是循环:
感知 → 思考 → 行动 → 观察 → 再次思考对应到 LLM 智能体中,常见形式是:
Thought:我需要先查询天气
Action:调用天气工具
Observation:天气晴,气温25℃
这个循环让智能体可以一边执行任务,一边根据反馈调整下一步。
二、智能体发展史
1、发展
符号主义 → 专家系统 → 早期智能体 → 强化学习 → 预训练模型 → LLM 智能体每一代智能体,都是为了解决上一代方法的局限。
2、符号主义 AI
早期人工智能主要受符号主义影响。 符号主义认为:智能就是对符号和规则进行推理。 例如:
IF 天空有乌云 AND 湿度高
THEN 可能要下雨
优点是逻辑清楚、可解释;缺点是规则需要人工编写,难以覆盖复杂现实。
3、专家系统
专家系统是符号主义 AI 的代表。 它把专家知识写成规则,让机器根据规则做判断。 一般包含三部分:
| 组成 | 作用 |
|---|---|
| 知识库 | 存放专家规则 |
| 推理机 | 根据规则推理 |
| 用户界面 | 与用户交互 |
典型规则形式:
IF 条件
THEN 结论
专家系统在医学诊断等领域有过成功应用,但也面临规则维护困难、常识不足等问题。
4、SHRDLU 与 ELIZA
SHRDLU
SHRDLU 是早期综合智能体,可以在“积木世界”中理解语言、规划动作并执行任务。 它展示了早期的智能体闭环:
理解语言 → 制定计划 → 执行动作 → 更新状态ELIZA
ELIZA 是早期聊天机器人。 它并不真正理解语言,而是通过关键词匹配和模板替换生成回复。 例如:
用户:我很焦虑
ELIZA:你为什么感到焦虑?
它说明:机器即使没有真正理解,也可以制造出“像是在理解”的效果。
5、符号主义的局限
符号主义主要有三个问题:
| 问题 | 含义 |
|---|---|
| 知识获取瓶颈 | 规则都要人工编写 |
| 常识不足 | 很多常识难以完整编码 |
| 系统脆弱 | 遇到规则外情况容易失败 |
因此,AI 后来逐渐转向“从数据中学习”。
6、强化学习
强化学习关注:智能体如何通过试错学习更好的行动策略。 基本流程是:
状态 → 行动 → 奖励 → 新状态 → 更新策略例如下棋 AI 通过大量对局,逐渐学会哪些策略更容易获胜。 强化学习强调的不是某一步最优,而是长期累计奖励最大。
7、预训练模型
预训练模型的思路是
先用海量数据学习通用知识
再适配具体任务
也就是:
预训练 → 微调大语言模型通过大规模文本预训练,学习了语言规律、事实知识和一定的推理能力。
8、LLM 驱动的现代智能体
现代智能体通常以大语言模型为核心,再结合工具、记忆和规划能力。 常见结构包括:
| 模块 | 作用 |
|---|---|
| LLM | 理解、推理、决策 |
| 记忆 | 保存历史信息 |
| 工具 | 调用搜索、代码、数据库等能力 |
| 规划 | 拆解复杂任务 |
| 观察反馈 | 根据结果调整下一步 |
它的工作方式可以概括为:
感知 → 规划 → 工具调用 → 观察反馈 → 继续执行9、三大思想流派
智能体发展中有三条重要路线:
| 流派 | 核心思想 |
|---|---|
| 符号主义 | 智能来自规则和逻辑推理 |
| 联结主义 | 智能来自神经网络和数据学习 |
| 行为主义 | 智能来自与环境交互和试错 |
现代 LLM 智能体可以看作三者融合:
LLM 本身来自联结主义
规划和工具调用带有符号主义特点
环境交互和反馈体现行为主义思想
三、大语言模型基础
1、语言模型与Transformer架构
从N-Gram 到 RNN
统计语言模型
在深度学习兴起前,通常使用统计方法:一个句子出现的概率,等于该句子中每个词出现的条件概率的连乘。
也被称为概率的链式法则。但 可能根本就不在语料库中,所以提出马尔可夫假设
马尔可夫假设 预测下一个token时不需要获取全部的词语,只需要看最近的几个词。 特点:简单,计算量小,但记忆太短 例如:
预测明天的天气,不需要过去一周的,只需要今天的
预测我爱北京天安门,只需要天安即可预测出门字,非马尔可夫假设也可以预测出门字,但需要左侧更多的信息
N-gram模型
看前面最近的 n-1 个词,然后统计历史上它后面最常出现什么词。 表示n-1个单词的上下文窗口大小。 例如:
bigram -> n=2 :可以看到前面1个字
trigram -> n=3 :可以看到前面2个字
4gram :可以看到前面3个字
ngram :表示可以看到前面n-1个字
特点:
- 数据稀疏性 (Sparsity) :如果一个词序列从未在语料库中出现,其概率估计就为 0,这显然是不合理的。虽然可以通过平滑 (Smoothing) 技术缓解,但无法根除。
- 泛化能力差:模型无法理解词与词之间的语义相似性。 例如:
1.语料库中只存在xx吃西红柿炒蛋,xx吃小炒牛肉等等,当输入文字为xx吃时,模型预测番茄炒蛋的概率为0
2.即使模型在语料库中见过很多次agent learns,它也无法将这个知识泛化到语义相似的词上。当计算 `robot learns` 的概率时,如果 `robot` 这个词从未出现过,或者 `robot learns` 这个组合从未出现过,模型计算出的概率也会是零。模型无法理解 `agent` 和 `robot` 在语义上的相似性。

后续的神经网络引入向量概念就解决了这个问题
神经网络语言模型与词嵌入
核心概念:
- 构建一个语义空间:创建一个立体的向量空间,将词汇表(词典/语料库)中的每个词映射到每个点上,这个点(向量)就被称为词嵌入/词向量,相近词或关联词在该空间中距离较近
- 学习从上下文到下一个词的映射:利用神经网络的强大拟合能力,来学习一个函数。这个函数的输入是前 n−1n−1 个词的词向量,输出是词汇表中每个词在当前上下文后出现的概率分布。
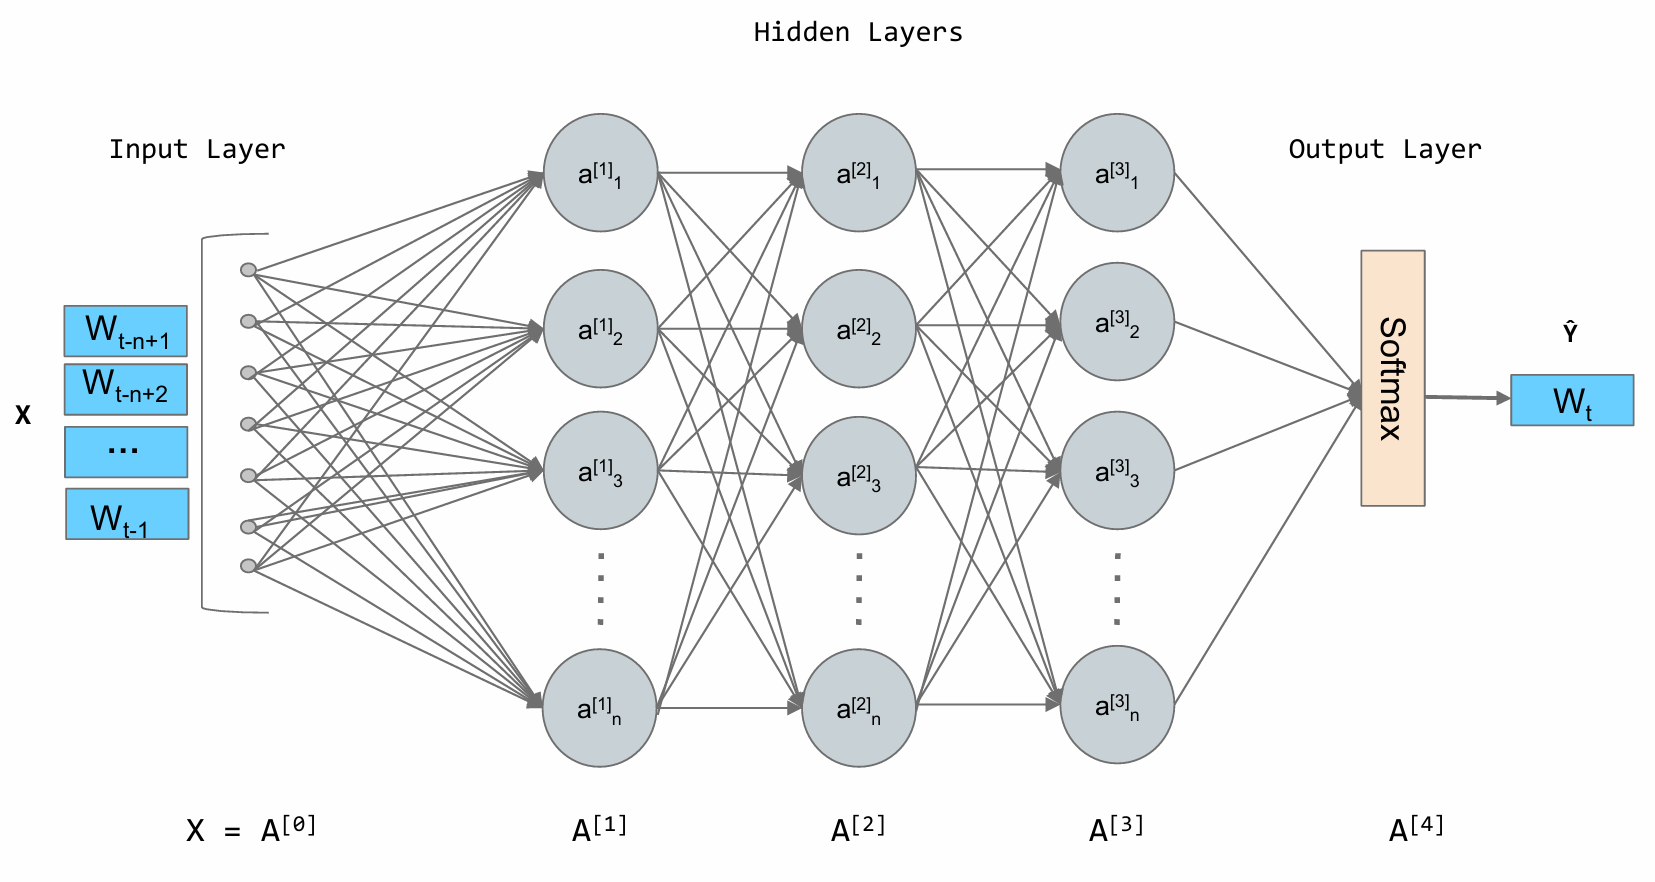
在上图架构中,模型在工作过程中会不断调整每个词的位置,然后通过余弦相似度 (Cosine Similarity) 来计算两个向量夹角的余弦来衡量它们的相识度。
这个公式的含义是:
- 如果两个向量方向完全相同,夹角为0°,余弦值为1,表示完全相关。
- 如果两个向量方向正交,夹角为90°,余弦值为0,表示毫无关系。
- 如果两个向量方向完全相反,夹角为180°,余弦值为-1,表示完全负相关。 神经网络语言模型通过词嵌入,成功解决了 N-gram 模型的泛化能力差的问题。但仍然有一个类似 N-gram 的限制:上下文窗口是固定的,它只能考虑固定数量的前文。
循环神经网络 (RNN) 与长短时记忆网络 (LSTM)
循环神经网络 (Recurrent Neural Network, RNN) 核心思想是:为网络增加记忆能力。RNN 中有一个重要概念,叫做隐藏状态,可以把它理解成模型的“短期记忆”。 例如:
读到“我” → 形成记忆1
读到“爱” → 结合“爱”和记忆1,形成记忆2
读到“北京” → 结合“北京”和记忆2,形成记忆3
读到“天安门” → 结合“天安门”和记忆3,形成记忆4
每一步都会将当前输入 + 上一步的记忆 转为 新的记忆与N-gram相比:它在结构上可以将前面读过的信息通过隐藏状态不断传递下去,因此相比 N-gram 和固定窗口神经网络,RNN 不再被严格限制在固定长度的上下文窗口内。不过,这种记忆是压缩在隐藏状态中的,随着序列变长,早期信息可能会逐渐衰减或被覆盖。
RNN的问题:记忆太短 为什么:
- 梯度消失:在100层神经网络中如果想调整最后的输出词,需要反向调整前面所有的参数,每一步都有误差导致梯度趋近于0
- 梯度爆炸:反之梯度变大
普通 RNN 虽然有“记忆”,但这个记忆并不可靠,尤其不擅长处理长句子、长文章中的远距离依赖关系。
长短时记忆网络 (Long Short-Term Memory, LSTM) 核心概念:
- 细胞状态(Cell State):普通RNN信息存储在隐藏状态中,LSTM存储在专门传递长期记忆的通道就叫细胞状态
- 门控机制(Gating Mechanism):
- 遗忘门:哪些旧信息应该被忘掉?
- 输入门:哪些新信息应该被记住?
- 输出门:当前应该输出哪些记忆?
==RNN:让神经网络有了记忆。 LSTM:让神经网络学会管理记忆。==
Transformer架构
RNN及LSTM通过引入循环结构来处理序列数据,这在一定程度上解决了捕捉长距离依赖的问题。然而,这种循环的计算方式也带来了新的瓶颈:它必须按顺序处理数据。第 t 个时间步的计算,必须等待第 t−1 个时间步完成后才能开始。这意味着 RNN 无法进行大规模的并行计算,在处理长序列时效率低下,这极大地限制了模型规模和训练速度的提升。Transformer在2017 年由谷歌团队提出。它完全抛弃了循环结构,转而完全依赖一种名为注意力 (Attention) 的机制来捕捉序列内的依赖关系,从而实现了真正意义上的并行计算。
Encoder-Decoder 整体结构
最初的 Transformer 模型是为端到端任务机器翻译而设计的。它在宏观上遵循了一个经典的编码器-解码器 (Encoder-Decoder) 架构。
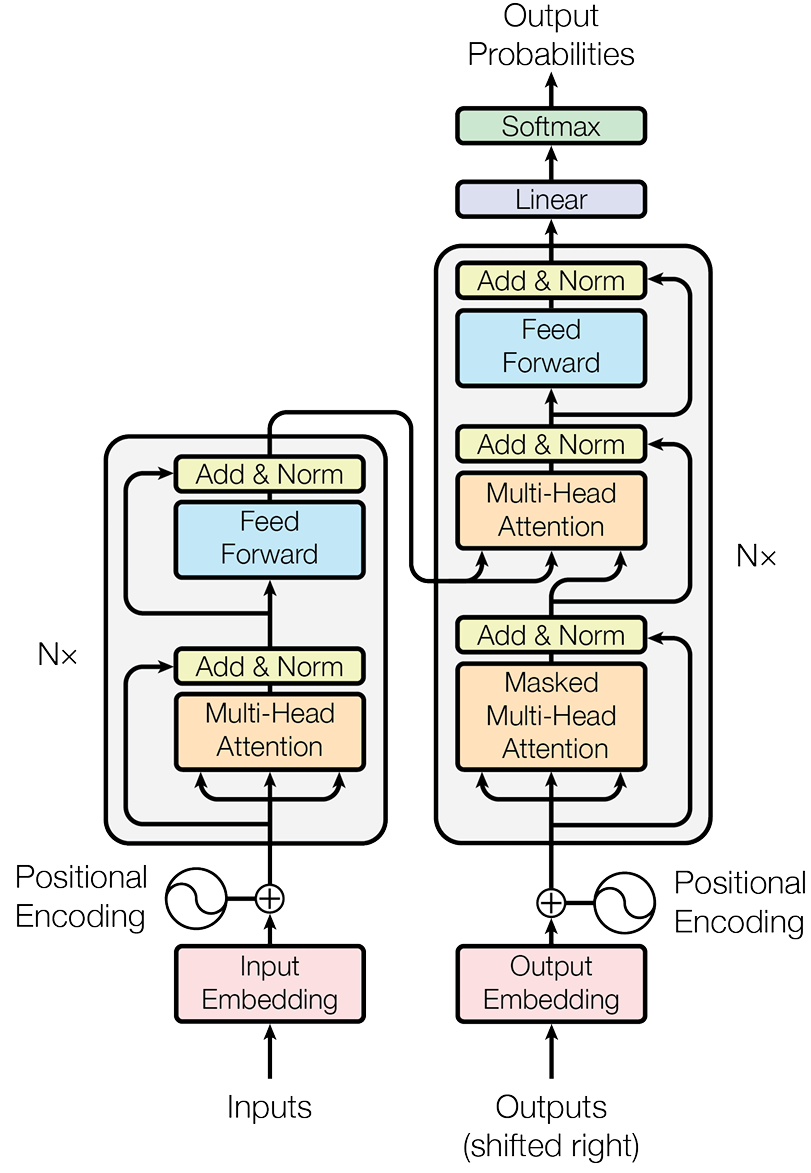
- 编码器:任务是“理解”输入的整个句子,把输入句子变成一组包含上下文信息的向量表示。
- 解码器:任务是“生成”目标句子,根据 Encoder 的理解结果,一个词一个词生成答案。
从自注意力到多头注意力
自注意力:在同一句话内部做注意力,Transformer 会让每个词都去看其他词,每个词都会重新理解自己。 例如
我买了一个苹果。
苹果发布了新手机。

第一个“苹果”是水果。
第二个“苹果”是公司。
Transformer 可以根据上下文动态调整词的含义。位置编码:
自注意力有个特点:它只看词之间的关系,不天然知道谁在前谁在后。所以引入位置编码,这样模型不仅知道词是什么,还知道词在哪里。由这个词是什么意思增强为这个词在某个位置上是什么意思。
注意力(Attention)在算什么: 例如:
一只猫追着老鼠,因为它很饿。
看到“它”时需要思考“它”指的是猫还是老鼠,再通过“很饿”猜测应该是“猫”饿了。
所以Transformer 和这个流程相似,每个词需要问三个问题
我现在需要找什么信息?    对应Transformer中的Query
别人能提供什么信息?    对应Transformer中的Key
别人本身携带什么内容?    对应Transformer中的Value
Attention 的本质是:根据相关性,从其他词那里取信息。
多头注意力: 一个注意力机制可能只关注一种关系,但语言里的关系很多。 例如:
主语和谓语的关系
代词和指代对象的关系
形容词和名词的关系
时间顺序关系
因果关系
所以:所以 Transformer 不只用一个 Attention,而是同时用多个 Attention。多个观察角度同时分析一句话,最后综合起来,模型就能更全面理解句子。
残差连接和 LayerNorm
- 残差连接:不要把原来的信息全部丢掉,而是在新信息上保留一条原始信息通道。
- 层归一化:把每一层输出调整到比较稳定的范围,避免数值太大或太小。
Transformer的优势
- 可以并行计算
- 擅长处理长距离依赖,词与词之间距离更远也不容易忘
- 多头注意力同时处理多种语言关系,不仅仅是记录与预测,而是学习
Decoder-only架构
Transformer的设计哲学是“先理解,再生成”。编码器负责深入理解输入的整个句子,形成一个包含全局信息的上下文记忆,然后解码器基于这份记忆来生成翻译。但 OpenAI 在开发 GPT (Generative Pre-trained Transformer) 时,提出了一个更简单的思想:语言的核心任务,不就是预测下一个最有可能出现的词吗?
无论是回答问题、写故事还是生成代码,本质上都是在一个已有的文本序列后面,一个词一个词地添加最合理的内容。基于这个思想,GPT 做了一个大胆的简化:它完全抛弃了编码器,只保留了解码器部分。 这就是 Decoder-Only 架构的由来。
三个特点:
- 只有解码器没有编码器:
- 掩码自注意力(Masked Self-Attention):模型在预测第 N 个词时,只能看到第 1 到 N-1 个词,看不到后面的词。这就是掩码
- 自回归(Auto-Regressive):文字接龙,预测出第一个词就把它加入到序列去生成第二个词,一直重复
2、与大语言模型交互
提示工程
通过设计更好的“输入提示词”,让大语言模型更稳定、更准确地完成任务。模型得到的上下文更明确,预测出来的内容就会更接近需求。 一个好的提示词通常包括:
角色:你是谁
任务:你要做什么
背景:相关信息是什么
要求:有什么限制
格式:按什么形式输出
示例:按某种格式分类模型参数:
temperature - 温度(随机程度):越低,模型越保守;越高,模型越发散,它是基于top参数的,top提供可选范围,temperature在这个范围里面选择
top_k - 预测时固定保留前 K 个 例如:10
top_P - 预测时按累计概率动态保留,更常用 默认:1
max_tokens - 模型最多输出多少token
stop - 指定模型遇到某些字符或文本时停止输出 例如:stop = ["###"] 模型生成到###时就会停止
presence_penalty - 控制模型是否倾向于引入新话题、新词 默认:0
frequency_penalty - 控制模型是否避免生成已经生成过多次的词 默认:0
seed - 控制模型在相同参数和输入的情况下,尽量生成相同的结果(只是理想状态)
文本分词
将一段连续的文本,切成模型能处理的小单位token,现代大语言模型普遍采用子词分词 (Subword Tokenization) 算法 既不能按字切,序列越长成本越高并且三个字和一个词意义不一样;也不能按词切,模型没见过某个词时就无法理解它的意思,例如:专业术语,拼写错误,网络用词
大模型常见的分词算法:
| 方法 | 常见模型 | 思想 |
|---|---|---|
| BPE | GPT 系列常用思想之一 | 常见组合就合并 |
| WordPiece | BERT 常用 | 对建模有帮助就合并 |
| Unigram | T5、LLaMA 等模型常见 | 先给很多候选,再删掉没用的 |
本地模型调用
"""展示 transformers 中 AutoTokenizer 和 AutoModelForCausalLM 的基础用法。"""

# ===== 启动入口说明 =====
# 这个示例需要安装 transformers 和 torch。
# 如果运行时报 ModuleNotFoundError,可以先安装:
#     uv add transformers torch
# 然后运行:
#     .venv/bin/python -m demo.transformers_auto_demo

# 本地 Hugging Face 格式模型目录。
# 这个目录和 Ollama 的模型目录不同,里面应该有 config.json、tokenizer.json、model.safetensors 等文件。
MODEL_PATH = "/Users/villow/LLM/huggingface/Qwen3-0.6B"
MAX_NEW_TOKENS = 300


def main() -> None:
    """程序入口:加载 tokenizer 和模型,然后生成一小段文本。"""

    # AutoTokenizer 负责把人类文本转换成模型能理解的 token id。
    # AutoModelForCausalLM 负责加载“因果语言模型”,也就是根据前文继续生成文本的模型。
    try:
        from transformers import AutoModelForCausalLM, AutoTokenizer
    except ModuleNotFoundError as error:
        raise SystemExit(
            "缺少 transformers 相关依赖。请先运行:uv add transformers torch"
        ) from error

    # 使用已经下载到本机的 Qwen3-0.6B 模型。
    # 因为是本地路径,所以 from_pretrained 不需要再去 Hugging Face 下载模型。
    model_name = MODEL_PATH

    # 加载 tokenizer。
    # from_pretrained 会根据 model_name 自动找到对应的 tokenizer 配置。
    tokenizer = AutoTokenizer.from_pretrained(model_name)

    # 加载因果语言模型。
    # AutoModelForCausalLM 会根据 model_name 自动选择合适的模型类。
    # device_map="auto" 会让 transformers 自动选择可用设备;没有 GPU 时通常会使用 CPU。
    # model = AutoModelForCausalLM.from_pretrained(model_name, device_map="auto")
    model = AutoModelForCausalLM.from_pretrained(model_name)

    # Qwen 这类聊天模型更推荐使用 messages 格式组织对话。
    messages = [
        {"role": "system", "content": "你是一个耐心的 Python 和 AI 学习助手。"},
        {
            "role": "user",
            "content": "用一句话解释 AutoTokenizer 和 AutoModelForCausalLM 的区别。",
        },
    ]

    # apply_chat_template 会把 messages 转成模型训练时更熟悉的聊天提示词格式。
    # add_generation_prompt=True 表示在最后加上“现在轮到助手回答”的提示。
    prompt = tokenizer.apply_chat_template(
        messages,
        tokenize=False,
        add_generation_prompt=True,
    )

    # tokenizer(...) 会把提示词字符串转换成模型输入。
    # return_tensors="pt" 表示返回 PyTorch Tensor,因为 transformers 默认常和 PyTorch 搭配使用。
    inputs = tokenizer(prompt, return_tensors="pt")

    # 把输入移动到模型所在设备上。
    # 如果模型在 CPU,这一步仍然是安全的;如果模型在 GPU/MPS,也能避免设备不一致。
    inputs = inputs.to(model.device)

    # generate 会让模型根据输入继续生成 token。
    # max_new_tokens 表示最多新生成多少个 token。
    output_ids = model.generate(
        **inputs,
        max_new_tokens=MAX_NEW_TOKENS,
        do_sample=False,
    )

    # 生成结果里会包含原始输入 token。
    # 这里把输入部分切掉,只保留模型新生成的回答。
    generated_ids = output_ids[0][inputs["input_ids"].shape[-1] :]

    # decode 会把新生成的 token id 转回人类可读文本。
    # skip_special_tokens=True 表示跳过模型内部用的特殊 token。
    output_text = tokenizer.decode(generated_ids, skip_special_tokens=True)

    # 打印模型路径和模型生成结果。
    print(f"模型路径:{model_name}")
    print(f"生成结果:{output_text}")


# 只有直接运行这个文件时,才会执行 main 函数。
if __name__ == "__main__":
    main()
输出:
Loading weights: 100%|████████████████████████████████████████████████████| 311/311 [00:00<00:00, 6059.27it/s]
模型路径:/Users/villow/LLM/huggingface/Qwen3-0.6B
生成结果:<think>
好的,用户让我用一句话解释AutoTokenizer和AutoModelForCausalLM的区别。首先,我需要明确这两个模型的区别。AutoTokenizer是用于构建模型的输入处理模块,负责将输入文本转换为模型可以处理的token序列。而AutoModelForCausalLM是模型本身,它使用这个tokenizer来生成输出。

接下来,我得考虑用户可能的背景。他们可能在学习NLP或机器学习,需要了解这两个组件的功能。用户可能没有直接问,但可能对模型结构感兴趣,或者想了解如何构建模型。需要确保解释清晰,避免术语过多,同时突出它们的核心作用。

然后,我需要检查是否有遗漏的关键点。比如,AutoTokenizer的作用是处理输入,而模型本身负责生成输出。可能用户需要知道它们的相互关系,比如tokenizer是模型的一部分,或者它们是独立的组件。需要确保一句话涵盖这两个主要区别,同时保持简洁。

最后,确保语言准确,没有错误。比如,确认AutoModelForCausalLM是用于生成输出的模型,而tokenizer是处理输入的。这样用户就能理解它们的区别,应用到实际项目中。
</think>

AutoTokenizer负责将输入文本转换为模型可处理的token序列,而AutoModelForCausalLM是构建模型的主体,通过该tokenizer生成输出。
3、缩放法则与幻觉
缩放法则
模型性能会随着模型参数量、训练数据量、训练计算量的增加,以相对平滑、可预测的方式提升。经典研究发现,语言模型的交叉熵损失会随模型规模、数据规模、计算量呈现近似幂律下降,而且这种趋势可以跨越多个数量级
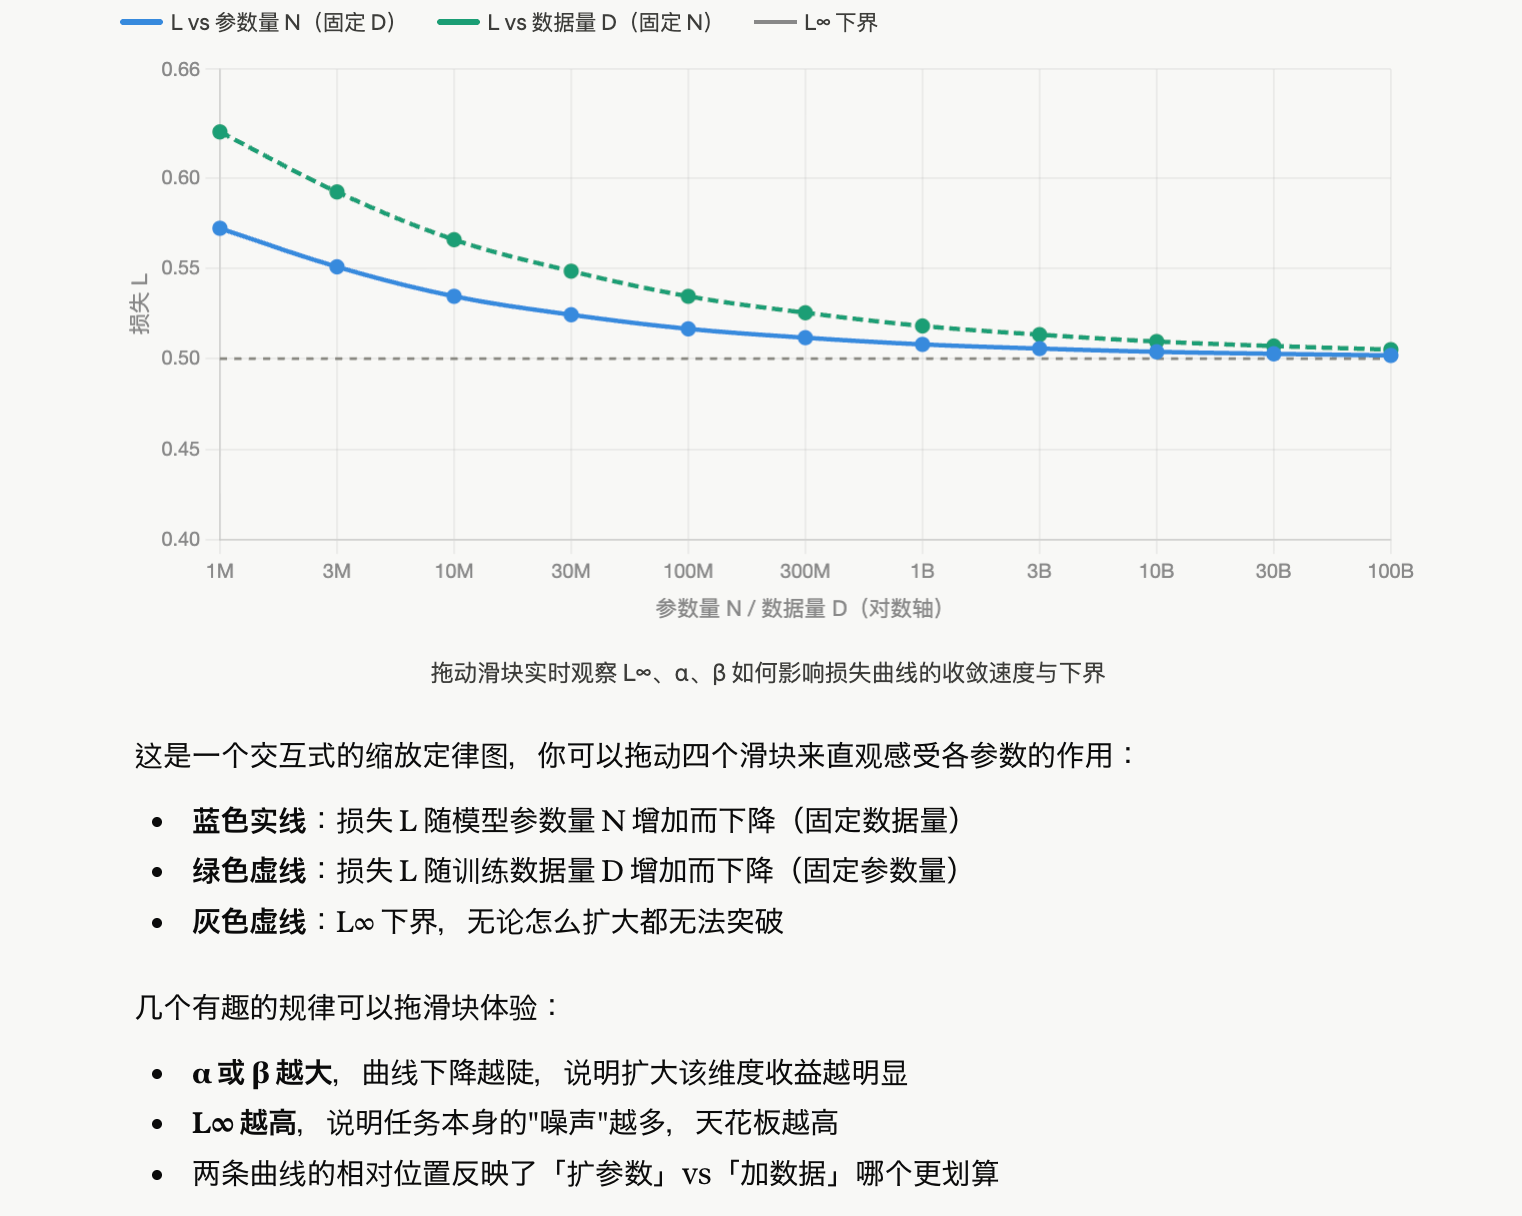
缩放法则就是大模型工程里的“投入—产出曲线”:更多参数、更多数据、更多算力通常会带来可预测的性能提升,但最佳做法不是盲目堆大,而是按计算预算平衡模型规模和数据规模
幻觉
模型生成了看起来很合理、语气很自信,但实际上不正确、无依据或与事实不一致的内容
**为什么会产生幻觉?**- 模型训练目标不是“保证真实”,而是“生成符合语言模式的文本”。如果某个错误答案在语言形式上很像正确答案,模型也可能生成它
- 模型可能缺少最新信息、专有信息或上下文信息。信息不够时,它有时会用模式补全,而不是主动承认不知道
- 用户问题本身可能有误导性。例如问“某某不存在的概念有什么优点”,模型可能顺着问题继续解释
- 模型对自身不确定性的表达不稳定。有时它并不知道自己不知道
幻觉和普通错误有什么区别? 普通错误可能是算错、理解错、信息过期 幻觉更强调:模型生成了没有依据的内容,并且表达得像真的一样。它的危险性在于“可信的语气”会掩盖“不可信的事实”
怎么减少幻觉? 比较有效的方法包括:
1. 让模型基于资料回答 - 例如上传文档、提供链接、给出数据库内容,让模型只根据材料作答
2. 要求引用来源 - 尤其是法律、医疗、金融、科研、新闻类问题,要让模型说明依据
3. 允许模型说不知道 - 提示中可以写:“如果没有依据,请直接说不知道,不要猜”
4. 使用检索增强生成,RAG - 先从可信知识库中检索相关资料,再让模型基于资料生成答案
5. 把任务拆小 - 复杂推理任务中,分步骤验证比一次性问大问题更可靠
6. 对高风险内容人工复核 - 合同、诊断、投资、学术引用、代码安全等场景不能只依赖模型输出
四、 智能体范式
1、ReAct (Reasoning + Acting)
含义:推理 + 行动,它是一种让大模型智能体“边思考、边行动”的工作方式
和普通的问答方式有什么区别:
- 普通大模型回答:用户问问题 → 模型直接回答
- ReAct回答:用户问问题→ 模型先思考→ 决定是否需要工具→ 调用工具→ 读取工具结果→ 再思考→ 最后回答 所以ReAct更适合搜索资料,调用api,操作数据库,执行代码,使用浏览器
编码实现
"""使用 LangChain 演示 ReAct 思想的 Agent 示例。

ReAct = Reasoning + Acting:
模型先根据问题进行推理,然后决定是否调用工具,再根据工具结果继续推理,最后给出答案。
"""

# ===== 启动入口说明 =====
# 在 IDE 里可以直接点击当前文件的 Run / 启动按钮。
# 在终端里可以运行:
#     .venv/bin/python -m demo.react_agent_demo

# ast 用来安全解析简单数学表达式,避免直接 eval 任意代码。
import ast

# importlib.util 用来按文件路径加载同目录里的 local_settings.py。
import importlib.util

# operator 提供安全的数学运算函数,例如加法、乘法。
import operator

# Path 用来定位当前文件所在目录。
from pathlib import Path

# create_agent 是 LangChain 1.x 中创建 Agent 的推荐入口。
from langchain.agents import create_agent

# ChatOpenAI 是 LangChain 提供的 OpenAI-compatible 聊天模型封装。
from langchain_openai import ChatOpenAI

# tool 装饰器可以把普通 Python 函数变成 Agent 可调用的工具。
from langchain_core.tools import tool


# 默认模型名:如果 local_settings.py 没配置 OPENAI_MODEL,就使用它。
DEFAULT_MODEL = "gpt-5.5"

# 默认请求地址:空字符串表示使用 OpenAI SDK 默认地址。
DEFAULT_BASE_URL = ""

# 默认问题:这个问题需要同时用到单词长度工具和计算器工具。
DEFAULT_QUESTION = "apple 这个单词的长度加上 12 * 3 等于多少?"


def main() -> None:
    """程序入口:创建模型、创建工具、运行 ReAct Agent。"""

    print("=== ReAct Agent Demo 启动 ===")

    # 加载项目内配置,避免污染其他项目的全局环境变量。
    print("阶段 1:读取 demo/local_settings.py 项目内配置...")
    settings = load_local_settings()

    # 创建 OpenAI-compatible 模型对象。
    print("阶段 2:根据配置创建 OpenAI-compatible 聊天模型...")
    llm = create_chat_model(settings)

    # 准备 Agent 可以调用的工具列表。
    print("阶段 3:注册 Agent 可用工具:word_length、calculator...")
    tools = [word_length, calculator]

    # system_prompt 用来告诉模型:你可以使用工具,并且要用 ReAct 风格解决问题。
    system_prompt = (
        "你是一个 ReAct Agent。遇到需要计算或查询的问题时,"
        "先判断应该调用哪个工具,再根据工具返回结果回答。"
    )

    # create_agent 会把模型和工具组装成一个 Agent。
    # debug=True 会在终端打印 Agent 的中间步骤,方便学习 ReAct 的执行过程。
    print("阶段 4:创建 LangChain Agent,并开启 debug 日志...")
    agent = create_agent(
        model=llm,
        tools=tools,
        system_prompt=system_prompt,
        debug=True,
    )

    # 用户问题。你可以改这个问题,观察 Agent 是否会选择不同工具。
    question = get_setting(settings, "REACT_DEMO_QUESTION", DEFAULT_QUESTION)
    print(f"阶段 5:准备用户问题:{question}")
    print("阶段 6:开始运行 Agent。下面会看到 LangChain debug 输出,包括模型消息和工具调用。")

    # LangChain Agent 使用 messages 格式输入,和聊天模型的消息结构一致。
    result = agent.invoke(
        {
            "messages": [
                {
                    "role": "user",
                    "content": question,
                }
            ]
        }
    )

    # Agent 的最终消息通常在 messages 列表最后一个位置。
    print("阶段 7:Agent 运行结束,提取最后一条模型消息作为最终回答。")
    final_message = result["messages"][-1]

    # content 是模型最终回答。
    print("\n最终回答:")
    print(get_message_text(final_message.content))


def load_local_settings():
    """加载当前目录下的 local_settings.py 配置文件。"""

    # __file__ 是当前 react_agent_demo.py 的文件路径。
    # with_name 会把文件名替换成 local_settings.py,从而定位同目录配置文件。
    settings_path = Path(__file__).with_name("local_settings.py")

    # 如果配置文件不存在,直接提示用户创建它。
    if not settings_path.exists():
        raise SystemExit("Missing demo/local_settings.py. 请先创建项目内配置文件。")

    # spec_from_file_location 可以从指定路径创建模块加载说明。
    spec = importlib.util.spec_from_file_location("local_settings", settings_path)
    if spec is None or spec.loader is None:
        raise SystemExit("Cannot load demo/local_settings.py.")

    # 根据加载说明创建模块对象。
    settings = importlib.util.module_from_spec(spec)

    # 执行配置文件,把里面的变量加载到 settings 对象上。
    spec.loader.exec_module(settings)
    return settings


def get_setting(settings, name: str, default: str) -> str:
    """从配置对象读取字符串配置;没有配置时使用默认值。"""

    # getattr 会按变量名读取配置,例如读取 settings.OPENAI_MODEL。
    value = getattr(settings, name, default)

    # 空字符串表示没有配置,所以回退到默认值。
    return value or default


def get_bool_setting(settings, name: str, default: bool) -> bool:
    """从配置对象读取布尔值配置;没有配置时使用默认值。"""

    # getattr 会按变量名读取配置,例如读取 settings.OPENAI_USE_RESPONSES_API。
    value = getattr(settings, name, default)

    # 如果配置本身就是 True 或 False,直接返回。
    if isinstance(value, bool):
        return value

    # 如果配置写成字符串,也支持常见写法,例如 "true"、"false"。
    if isinstance(value, str):
        return value.strip().lower() in {"1", "true", "yes", "on"}

    # 其他类型不做复杂处理,回退到默认值。
    return default


def create_chat_model(settings) -> ChatOpenAI:
    """根据 local_settings.py 创建 OpenAI-compatible 聊天模型。"""

    # 从项目内配置读取模型参数。
    api_key = get_setting(settings, "OPENAI_API_KEY", "")
    base_url = get_setting(settings, "OPENAI_BASE_URL", DEFAULT_BASE_URL)
    model = get_setting(settings, "OPENAI_MODEL", DEFAULT_MODEL)
    use_responses_api = get_bool_setting(settings, "OPENAI_USE_RESPONSES_API", False)

    # 没有 API Key 时,直接给出明确提示。
    if not api_key:
        raise SystemExit("Missing OPENAI_API_KEY. 请先在 demo/local_settings.py 中配置。")

    # 准备 ChatOpenAI 初始化参数。
    model_kwargs = {
        "model": model,
        "api_key": api_key,
        "use_responses_api": use_responses_api,
    }

    # 如果配置了 base_url,请求会走这个 OpenAI-compatible 地址。
    if base_url:
        model_kwargs["base_url"] = base_url

    # 返回 LangChain 聊天模型对象。
    return ChatOpenAI(**model_kwargs)


def get_message_text(content) -> str:
    """把模型返回内容统一转换成普通文本。"""

    # 有些接口会直接返回字符串,这种情况直接返回。
    if isinstance(content, str):
        return content

    # Responses API 常见返回格式是列表,里面每一项是一个字典。
    if isinstance(content, list):
        texts = []

        # 遍历列表,提取 type 为 text 的文本块。
        for item in content:
            if isinstance(item, dict) and item.get("type") == "text":
                texts.append(item.get("text", ""))

        # 用换行拼接多个文本块。
        return "\n".join(text for text in texts if text)

    # 如果遇到其他格式,转成字符串,避免程序报错。
    return str(content)


@tool
def word_length(word: str) -> int:
    """计算一个英文单词的字符数量。"""

    # strip 会去掉单词两侧的空白字符。
    return len(word.strip())


@tool
def calculator(expression: str) -> float:
    """计算只包含加减乘除和括号的数学表达式。"""

    # ast.parse 会把表达式字符串解析成 Python 语法树。
    tree = ast.parse(expression, mode="eval")

    # 递归计算语法树。
    return evaluate_math_node(tree.body)


def evaluate_math_node(node) -> float:
    """递归计算安全的数学表达式节点。"""

    # 支持数字常量,例如 12、3.5。
    if isinstance(node, ast.Constant) and isinstance(node.value, int | float):
        return node.value

    # 支持一元负号,例如 -3。
    if isinstance(node, ast.UnaryOp) and isinstance(node.op, ast.USub):
        return -evaluate_math_node(node.operand)

    # 支持二元运算,例如 12 * 3。
    if isinstance(node, ast.BinOp):
        left = evaluate_math_node(node.left)
        right = evaluate_math_node(node.right)

        # 只允许常见四则运算,避免执行任意 Python 代码。
        operators = {
            ast.Add: operator.add,
            ast.Sub: operator.sub,
            ast.Mult: operator.mul,
            ast.Div: operator.truediv,
        }

        # 根据语法树里的运算符类型,找到对应的安全计算函数。
        operation = operators.get(type(node.op))
        if operation is None:
            raise ValueError("只支持加、减、乘、除。")

        # 返回计算结果。
        return operation(left, right)

    # 其他节点一律拒绝,例如函数调用、变量名、属性访问等。
    raise ValueError("表达式不安全或不支持。")


# 只有直接运行这个文件时才执行 main;被其他文件 import 时不会自动执行。
if __name__ == "__main__":
    main()
输出:
=== ReAct Agent Demo 启动 ===
阶段 1:读取 demo/local_settings.py 项目内配置...
阶段 2:根据配置创建 OpenAI-compatible 聊天模型...
阶段 3:注册 Agent 可用工具:word_length、calculator...
阶段 4:创建 LangChain Agent,并开启 debug 日志...
阶段 5:准备用户问题:apple 这个单词的长度加上 12 * 3 等于多少?
阶段 6:开始运行 Agent。下面会看到 LangChain debug 输出,包括模型消息和工具调用。
[values] {'messages': [HumanMessage(content='apple 这个单词的长度加上 12 * 3 等于多少?', additional_kwargs={}, response_metadata={}, id='e0540787-b59e-40b9-98ce-6e25a76791a7')]}
[updates] {'model': {'messages': [AIMessage(content=[{'arguments': '{"word":"apple"}', 'call_id': 'call_cnKHTRAsdboqXtx4mR6m40Ka', 'name': 'word_length', 'type': 'function_call'}, {'arguments': '{"expression":"12*3"}', 'call_id': 'call_iA63aK83UISglvgJLqR5NuPK', 'name': 'calculator', 'type': 'function_call'}], additional_kwargs={}, response_metadata={'id': 'resp_00710547bebdb972016a16af3cdf308199b7e879342b8c2a53', 'created_at': 1779871548.0, 'metadata': {}, 'model': 'gpt-5.5', 'object': 'response', 'service_tier': 'default', 'status': 'completed', 'model_provider': 'openai', 'model_name': 'gpt-5.5'}, id='resp_00710547bebdb972016a16af3cdf308199b7e879342b8c2a53', tool_calls=[{'name': 'word_length', 'args': {'word': 'apple'}, 'id': 'call_cnKHTRAsdboqXtx4mR6m40Ka', 'type': 'tool_call'}, {'name': 'calculator', 'args': {'expression': '12*3'}, 'id': 'call_iA63aK83UISglvgJLqR5NuPK', 'type': 'tool_call'}], invalid_tool_calls=[], usage_metadata={'input_tokens': 133, 'output_tokens': 87, 'total_tokens': 220, 'input_token_details': {'cache_read': 0}, 'output_token_details': {'reasoning': 35}})]}}
xxx...
阶段 7:Agent 运行结束,提取最后一条模型消息作为最终回答。

最终回答:
apple 的长度是 5,12 × 3 = 36,所以:

5 + 36 = **41**
ReAct 的主要特点
ReAct 的核心是 边思考、边行动。
- 可解释性强:通过 Thought 可以看到智能体每一步为什么这么做,方便理解和调试
- 能动态调整:它不是一次性把计划定死,而是根据工具返回的 Observation,不断修正下一步行动
- 适合工具协同:LLM 负责推理和规划,工具负责搜索、计算、查询等具体任务,两者配合完成复杂问题
局限性
- 效率较低:因为它需要多轮“思考—行动—观察”,所以耗时和成本都会增加
- 提示词不稳定:ReAct 很依赖提示词模板,提示词稍微变化,模型行为可能就不一样
- 可能陷入局部最优:它是一步步决策的,可能只关注当前结果,缺少全局规划,甚至反复尝试同一类错误路径
2、Plan-and-Solve
含义:计划和解决,先把问题拆成步骤,再按照步骤一步步解决
编码实现
|fold
"""使用 LangChain 演示 Plan-and-Solve 思想。

Plan-and-Solve = 先规划,再求解:
模型先把复杂问题拆成清晰步骤,然后再按照计划逐步解决问题。
"""

# ===== 启动入口说明 =====
# 在 IDE 里可以直接点击当前文件的 Run / 启动按钮。
# 在终端里可以运行:
#     .venv/bin/python -m demo.plan_and_solve_demo

# importlib.util 用来按文件路径加载同目录里的 local_settings.py。
import importlib.util

# Path 用来定位当前文件所在目录。
from pathlib import Path

# ChatOpenAI 是 LangChain 提供的 OpenAI-compatible 聊天模型封装。
from langchain_openai import ChatOpenAI


# 默认模型名:如果 local_settings.py 没配置 OPENAI_MODEL,就使用它。
DEFAULT_MODEL = "gpt-5.5"

# 默认请求地址:空字符串表示使用 OpenAI SDK 默认地址。
DEFAULT_BASE_URL = ""

# 默认问题:刻意换成旅行预算问题,和 ReAct demo 的算术问题区分开。
DEFAULT_QUESTION = (
    "我计划周末去上海玩 2 天。高铁往返 560 元,酒店每晚 380 元,"
    "每天餐饮 150 元,景点门票总共 220 元。请帮我计算总预算,"
    "并判断 1800 元预算是否够。"
)


def main() -> None:
    """程序入口:先让模型制定计划,再让模型按计划解决问题。"""

    print("=== Plan-and-Solve Demo 启动 ===")

    # 加载项目内配置,避免污染其他项目的全局环境变量。
    print("阶段 1:读取 demo/local_settings.py 项目内配置...")
    settings = load_local_settings()

    # 创建 OpenAI-compatible 模型对象。
    print("阶段 2:根据配置创建 OpenAI-compatible 聊天模型...")
    llm = create_chat_model(settings)

    # 准备用户问题。
    question = get_setting(settings, "PLAN_AND_SOLVE_DEMO_QUESTION", DEFAULT_QUESTION)
    print(f"阶段 3:准备用户问题:{question}")

    # Plan 阶段:先让模型只制定计划,不直接求最终答案。
    print("阶段 4:Plan 阶段,让模型先拆解解决步骤...")
    plan = make_plan(llm, question)
    print("\n模型生成的计划:")
    print(plan)

    # Solve 阶段:把问题和计划一起交给模型,让它按计划求解。
    print("\n阶段 5:Solve 阶段,让模型按照计划逐步解决问题...")
    answer = solve_with_plan(llm, question, plan)

    # 打印最终回答。
    print("\n最终回答:")
    print(answer)


def load_local_settings():
    """加载当前目录下的 local_settings.py 配置文件。"""

    # __file__ 是当前 plan_and_solve_demo.py 的文件路径。
    # with_name 会把文件名替换成 local_settings.py,从而定位同目录配置文件。
    settings_path = Path(__file__).with_name("local_settings.py")

    # 如果配置文件不存在,直接提示用户创建它。
    if not settings_path.exists():
        raise SystemExit("Missing demo/local_settings.py. 请先创建项目内配置文件。")

    # spec_from_file_location 可以从指定路径创建模块加载说明。
    spec = importlib.util.spec_from_file_location("local_settings", settings_path)
    if spec is None or spec.loader is None:
        raise SystemExit("Cannot load demo/local_settings.py.")

    # 根据加载说明创建模块对象。
    settings = importlib.util.module_from_spec(spec)

    # 执行配置文件,把里面的变量加载到 settings 对象上。
    spec.loader.exec_module(settings)
    return settings


def get_setting(settings, name: str, default: str) -> str:
    """从配置对象读取字符串配置;没有配置时使用默认值。"""

    # getattr 会按变量名读取配置,例如读取 settings.OPENAI_MODEL。
    value = getattr(settings, name, default)

    # 空字符串表示没有配置,所以回退到默认值。
    return value or default


def get_bool_setting(settings, name: str, default: bool) -> bool:
    """从配置对象读取布尔值配置;没有配置时使用默认值。"""

    # getattr 会按变量名读取配置,例如读取 settings.OPENAI_USE_RESPONSES_API。
    value = getattr(settings, name, default)

    # 如果配置本身就是 True 或 False,直接返回。
    if isinstance(value, bool):
        return value

    # 如果配置写成字符串,也支持常见写法,例如 "true"、"false"。
    if isinstance(value, str):
        return value.strip().lower() in {"1", "true", "yes", "on"}

    # 其他类型不做复杂处理,回退到默认值。
    return default


def create_chat_model(settings) -> ChatOpenAI:
    """根据 local_settings.py 创建 OpenAI-compatible 聊天模型。"""

    # 从项目内配置读取模型参数。
    api_key = get_setting(settings, "OPENAI_API_KEY", "")
    base_url = get_setting(settings, "OPENAI_BASE_URL", DEFAULT_BASE_URL)
    model = get_setting(settings, "OPENAI_MODEL", DEFAULT_MODEL)
    use_responses_api = get_bool_setting(settings, "OPENAI_USE_RESPONSES_API", False)

    # 没有 API Key 时,直接给出明确提示。
    if not api_key:
        raise SystemExit("Missing OPENAI_API_KEY. 请先在 demo/local_settings.py 中配置。")

    # 准备 ChatOpenAI 初始化参数。
    model_kwargs = {
        "model": model,
        "api_key": api_key,
        "use_responses_api": use_responses_api,
    }

    # 如果配置了 base_url,请求会走这个 OpenAI-compatible 地址。
    if base_url:
        model_kwargs["base_url"] = base_url

    # 返回 LangChain 聊天模型对象。
    return ChatOpenAI(**model_kwargs)


def make_plan(llm: ChatOpenAI, question: str) -> str:
    """Plan 阶段:只生成解题计划。"""

    # 明确告诉模型:这里只要计划,不要最终答案。
    prompt = f"""
你正在执行 Plan-and-Solve 的 Plan 阶段。
请只为下面的问题制定解题计划,不要直接计算最终答案。

要求:
1. 用中文输出。
2. 使用编号列表。
3. 每一步都要具体说明要计算或判断什么。

问题:
{question}
"""

    # 调用模型生成计划。
    response = llm.invoke(prompt)

    # 把不同接口格式的返回内容统一转成普通文本。
    return get_message_text(response.content)


def solve_with_plan(llm: ChatOpenAI, question: str, plan: str) -> str:
    """Solve 阶段:根据计划逐步解决问题。"""

    # 把原问题和 Plan 阶段生成的计划一起给模型。
    prompt = f"""
你正在执行 Plan-and-Solve 的 Solve 阶段。
请严格按照给定计划一步步解决问题,并给出最终结论。

原问题:
{question}

计划:
{plan}

要求:
1. 展示关键计算过程。
2. 最后明确回答预算是否足够。
3. 用中文回答。
"""

    # 调用模型生成解答。
    response = llm.invoke(prompt)

    # 把不同接口格式的返回内容统一转成普通文本。
    return get_message_text(response.content)


def get_message_text(content) -> str:
    """把模型返回内容统一转换成普通文本。"""

    # 有些接口会直接返回字符串,这种情况直接返回。
    if isinstance(content, str):
        return content

    # Responses API 常见返回格式是列表,里面每一项是一个字典。
    if isinstance(content, list):
        texts = []

        # 遍历列表,提取 type 为 text 的文本块。
        for item in content:
            if isinstance(item, dict) and item.get("type") == "text":
                texts.append(item.get("text", ""))

        # 用换行拼接多个文本块。
        return "\n".join(text for text in texts if text)

    # 如果遇到其他格式,转成字符串,避免程序报错。
    return str(content)


# 只有直接运行这个文件时才执行 main;被其他文件 import 时不会自动执行。
if __name__ == "__main__":
    main()
输出:
=== Plan-and-Solve Demo 启动 ===
阶段 1:读取 1start/local_settings.py 项目内配置...
阶段 2:根据配置创建 OpenAI-compatible 聊天模型...
阶段 3:准备用户问题:我计划周末去上海玩 2 天。高铁往返 560 元,酒店每晚 380 元,每天餐饮 150 元,景点门票总共 220 元。请帮我计算总预算,并判断 1800 元预算是否够。
阶段 4:Plan 阶段,让模型先拆解解决步骤...

模型生成的计划:
1. 计算交通费用:确认高铁往返费用为 **560 元**,作为总交通预算。

2. 计算酒店费用:判断 2 天行程通常需要住几晚;如果是周末玩 2 天,一般按 **1 晚酒店** 计算,再用“每晚 380 元 × 住宿晚数”得到酒店总费用。

3. 计算餐饮费用:用“每天餐饮 150 元 × 2 天”计算 2 天的餐饮总费用。

4. 计算景点门票费用:将题目给出的景点门票总费用 **220 元**计入预算。

5. 计算总预算:把交通费用、酒店费用、餐饮费用和景点门票费用相加,得到本次上海 2 天游玩的总预算。

6. 判断 1800 元是否够:将计算出的总预算与 **1800 元**进行比较;如果总预算小于或等于 1800 元,则预算够;如果总预算大于 1800 元,则预算不够。

7. 如有剩余预算:用“1800 元 − 总预算”计算剩余金额;如果不够,则用“总预算 − 1800 元”计算超出金额。

阶段 5:Solve 阶段,让模型按照计划逐步解决问题...

最终回答:
按计划计算如下:

1. **交通费用**
   高铁往返费用:**560 元**

2. **酒店费用**
   周末玩 2 天,一般按住 **1 晚**计算:
   380 × 1 = **380 元**

3. **餐饮费用**
   每天餐饮 150 元,2 天:
   150 × 2 = **300 元**

4. **景点门票费用**
   景点门票总共:**220 元**

5. **总预算计算**
   总预算 = 交通费 + 酒店费 + 餐饮费 + 景点门票
   = 560 + 380 + 300 + 220
   = **1460 元**

6. **判断 1800 元是否够**
   1800 元 − 1460 元 = **340 元**

最终结论:**1800 元预算足够**,预计总花费为 **1460 元**,还剩 **340 元**。
Plan-and-Solve的主要特点
- 结构清晰:先列计划,回答不会太偏差太大
- 减少遗漏步骤:先把任务拆开,不容易漏掉关键环节
- 适合复杂任务:比如分析、推理、写方案、解决数学题、多步骤决策等
局限性
- 计划可能一开始就错了:如果第一步计划不合理,后面执行也会跟着错
- 缺少动态纠错能力:不会像ReAct一样根据工具返回结果进行调整
3、Reflection
含义:反思,先完成一次任务,然后回头检查自己的结果,发现问题,再进行修改和优化 核心工作流程可以概括为一个简洁的三步循环:执行 -> 反思 -> 优化
- **执行 (Execution)**:首先,智能体使用我们熟悉的方法(如 ReAct 或 Plan-and-Solve)尝试完成任务,生成一个初步的解决方案或行动轨迹。这可以看作是“初稿”。
- **反思 (Reflection)**:接着,智能体进入反思阶段。它会调用一个独立的、或者带有特殊提示词的大语言模型实例,来扮演一个“评审员”的角色。这个“评审员”会审视第一步生成的“初稿”,并从多个维度进行评估,例如:
- **优化 (Refinement)**:最后,智能体将“初稿”和“反馈”作为新的上下文,再次调用大语言模型,要求它根据反馈内容对初稿进行修正,生成一个更完善的“修订稿”。
编码实现
"""使用 LangChain 演示 Reflection 反思模式。

Reflection = 先生成答案,再检查答案,再根据检查结果改进答案。
这个模式适合写作、解释、总结、代码审查等需要提高质量的任务。
"""

# ===== 启动入口说明 =====
# 在 IDE 里可以直接点击当前文件的 Run / 启动按钮。
# 在终端里可以运行:
#     .venv/bin/python -m demo.reflection_demo

# importlib.util 用来按文件路径加载同目录里的 local_settings.py。
import importlib.util

# Path 用来定位当前文件所在目录。
from pathlib import Path

# ChatOpenAI 是 LangChain 提供的 OpenAI-compatible 聊天模型封装。
from langchain_openai import ChatOpenAI


# 默认模型名:如果 local_settings.py 没配置 OPENAI_MODEL,就使用它。
DEFAULT_MODEL = "gpt-5.5"

# 默认请求地址:空字符串表示使用 OpenAI SDK 默认地址。
DEFAULT_BASE_URL = ""

# 默认问题:选择一个适合初学者学习的 Python 问题,方便观察反思前后的变化。
DEFAULT_QUESTION = "请解释 Python 中列表和元组的区别,并给一个适合初学者的例子。"


def main() -> None:
    """程序入口:生成初稿、反思初稿、根据反思改进答案。"""

    print("=== Reflection Demo 启动 ===")

    # 加载项目内配置,避免污染其他项目的全局环境变量。
    print("阶段 1:读取 demo/local_settings.py 项目内配置...")
    settings = load_local_settings()

    # 创建 OpenAI-compatible 模型对象。
    print("阶段 2:根据配置创建 OpenAI-compatible 聊天模型...")
    llm = create_chat_model(settings)

    # 准备用户问题。
    question = get_setting(settings, "REFLECTION_DEMO_QUESTION", DEFAULT_QUESTION)
    print(f"阶段 3:准备用户问题:{question}")

    # Draft 阶段:先让模型直接回答,得到第一版答案。
    print("阶段 4:Draft 初稿阶段,先让模型直接回答问题...")
    draft = create_draft(llm, question)
    print("\n初稿答案:")
    print(draft)

    # Reflect 阶段:让模型检查初稿有哪些问题。
    print("\n阶段 5:Reflect 反思阶段,检查初稿是否有遗漏、跳跃或表达不清...")
    reflection = reflect_on_draft(llm, question, draft)
    print("\n反思意见:")
    print(reflection)

    # Revise 阶段:让模型根据反思意见改进答案。
    print("\n阶段 6:Revise 改进阶段,根据反思意见生成最终答案...")
    revised_answer = revise_answer(llm, question, draft, reflection)

    # 打印最终答案。
    print("\n最终答案:")
    print(revised_answer)


def load_local_settings():
    """加载当前目录下的 local_settings.py 配置文件。"""

    # __file__ 是当前 reflection_demo.py 的文件路径。
    # with_name 会把文件名替换成 local_settings.py,从而定位同目录配置文件。
    settings_path = Path(__file__).with_name("local_settings.py")

    # 如果配置文件不存在,直接提示用户创建它。
    if not settings_path.exists():
        raise SystemExit("Missing demo/local_settings.py. 请先创建项目内配置文件。")

    # spec_from_file_location 可以从指定路径创建模块加载说明。
    spec = importlib.util.spec_from_file_location("local_settings", settings_path)
    if spec is None or spec.loader is None:
        raise SystemExit("Cannot load 1start/local_settings.py.")

    # 根据加载说明创建模块对象。
    settings = importlib.util.module_from_spec(spec)

    # 执行配置文件,把里面的变量加载到 settings 对象上。
    spec.loader.exec_module(settings)
    return settings


def get_setting(settings, name: str, default: str) -> str:
    """从配置对象读取字符串配置;没有配置时使用默认值。"""

    # getattr 会按变量名读取配置,例如读取 settings.OPENAI_MODEL。
    value = getattr(settings, name, default)

    # 空字符串表示没有配置,所以回退到默认值。
    return value or default


def get_bool_setting(settings, name: str, default: bool) -> bool:
    """从配置对象读取布尔值配置;没有配置时使用默认值。"""

    # getattr 会按变量名读取配置,例如读取 settings.OPENAI_USE_RESPONSES_API。
    value = getattr(settings, name, default)

    # 如果配置本身就是 True 或 False,直接返回。
    if isinstance(value, bool):
        return value

    # 如果配置写成字符串,也支持常见写法,例如 "true"、"false"。
    if isinstance(value, str):
        return value.strip().lower() in {"1", "true", "yes", "on"}

    # 其他类型不做复杂处理,回退到默认值。
    return default


def create_chat_model(settings) -> ChatOpenAI:
    """根据 local_settings.py 创建 OpenAI-compatible 聊天模型。"""

    # 从项目内配置读取模型参数。
    api_key = get_setting(settings, "OPENAI_API_KEY", "")
    base_url = get_setting(settings, "OPENAI_BASE_URL", DEFAULT_BASE_URL)
    model = get_setting(settings, "OPENAI_MODEL", DEFAULT_MODEL)
    use_responses_api = get_bool_setting(settings, "OPENAI_USE_RESPONSES_API", False)

    # 没有 API Key 时,直接给出明确提示。
    if not api_key:
        raise SystemExit("Missing OPENAI_API_KEY. 请先在 demo/local_settings.py 中配置。")

    # 准备 ChatOpenAI 初始化参数。
    model_kwargs = {
        "model": model,
        "api_key": api_key,
        "use_responses_api": use_responses_api,
    }

    # 如果配置了 base_url,请求会走这个 OpenAI-compatible 地址。
    if base_url:
        model_kwargs["base_url"] = base_url

    # 返回 LangChain 聊天模型对象。
    return ChatOpenAI(**model_kwargs)


def create_draft(llm: ChatOpenAI, question: str) -> str:
    """Draft 阶段:生成第一版答案。"""

    # 这里故意只要求“直接回答”,让初稿可能存在可改进空间。
    prompt = f"""
请直接回答下面的问题,面向 Python 初学者,语言尽量简洁。

问题:
{question}
"""

    # 调用模型生成初稿。
    response = llm.invoke(prompt)

    # 把不同接口格式的返回内容统一转成普通文本。
    return get_message_text(response.content)


def reflect_on_draft(llm: ChatOpenAI, question: str, draft: str) -> str:
    """Reflect 阶段:反思初稿有什么可以改进。"""

    # 反思阶段不要求重新回答,而是要求模型扮演审稿人。
    prompt = f"""
你正在执行 Reflection 模式的 Reflect 阶段。
请检查下面的初稿答案,指出它可以改进的地方。

原问题:
{question}

初稿答案:
{draft}

请从下面角度反思:
1. 是否遗漏关键信息?
2. 是否有逻辑跳跃?
3. 是否有表达不清的地方?
4. 是否需要补充更适合初学者的例子?
5. 是否存在事实错误?

只输出反思意见,不要直接重写最终答案。
"""

    # 调用模型生成反思意见。
    response = llm.invoke(prompt)

    # 把不同接口格式的返回内容统一转成普通文本。
    return get_message_text(response.content)


def revise_answer(llm: ChatOpenAI, question: str, draft: str, reflection: str) -> str:
    """Revise 阶段:根据反思意见改进答案。"""

    # 改进阶段把原问题、初稿和反思意见都交给模型。
    prompt = f"""
你正在执行 Reflection 模式的 Revise 阶段。
请根据反思意见,重写并改进答案。

原问题:
{question}

初稿答案:
{draft}

反思意见:
{reflection}

要求:
1. 面向 Python 初学者。
2. 解释要清楚但不要啰嗦。
3. 必须包含一个简单代码例子。
4. 最后用一句话总结列表和元组的核心区别。
"""

    # 调用模型生成最终答案。
    response = llm.invoke(prompt)

    # 把不同接口格式的返回内容统一转成普通文本。
    return get_message_text(response.content)


def get_message_text(content) -> str:
    """把模型返回内容统一转换成普通文本。"""

    # 有些接口会直接返回字符串,这种情况直接返回。
    if isinstance(content, str):
        return content

    # Responses API 常见返回格式是列表,里面每一项是一个字典。
    if isinstance(content, list):
        texts = []

        # 遍历列表,提取 type 为 text 的文本块。
        for item in content:
            if isinstance(item, dict) and item.get("type") == "text":
                texts.append(item.get("text", ""))

        # 用换行拼接多个文本块。
        return "\n".join(text for text in texts if text)

    # 如果遇到其他格式,转成字符串,避免程序报错。
    return str(content)


# 只有直接运行这个文件时才执行 main;被其他文件 import 时不会自动执行。
if __name__ == "__main__":
    main()
输出:
=== Reflection Demo 启动 ===
阶段 1:读取 demo/local_settings.py 项目内配置...
阶段 2:根据配置创建 OpenAI-compatible 聊天模型...
阶段 3:准备用户问题:请解释 Python 中列表和元组的区别,并给一个适合初学者的例子。
阶段 4:Draft 初稿阶段,先让模型直接回答问题...

初稿答案:
Python 中**列表(list)**和**元组(tuple)**都可以用来存放多个数据。

主要区别:


1. **列表可以修改**
   - 用 `[]`
   - 可以添加、删除、修改元素

2. **元组不能修改**
   - 用 `()`
   - 创建后内容不能改变

例子:

```python
# 列表
fruits = ["苹果", "香蕉", "橙子"]
fruits[0] = "西瓜"   # 可以修改
fruits.append("葡萄") # 可以添加

print(fruits)
```

输出:

```python
['西瓜', '香蕉', '橙子', '葡萄']
```

元组例子:

```python
# 元组
colors = ("红色", "绿色", "蓝色")
print(colors[0])
```

如果这样写会报错:

```python
colors[0] = "黄色"  # 元组不能修改
```

简单记忆:

- **列表 list**:适合存放以后可能会改变的数据
- **元组 tuple**:适合存放固定不变的数据

阶段 5:Reflect 反思阶段,检查初稿是否有遗漏、跳跃或表达不清...

反思意见:
反思意见如下:

1. **关键信息基本完整,但可以补充一点**
   - 已经说明了列表和元组的核心区别:列表可修改,元组不可修改。
   - 可以补充说明它们的共同点,例如:
     - 都可以存放多个数据;
     - 都可以通过下标访问元素;
     - 都可以遍历;
     - 都可以存放不同类型的数据。
   - 这样初学者能更清楚地理解“它们相似在哪里,区别在哪里”。

2. **“元组不能修改”可以表达得更准确**
   - 初稿说“元组不能修改”对初学者来说基本正确。
   - 但如果更严谨,可以说明:元组本身不可变,不能增加、删除、替换元素。
   - 不过不建议在初学者答案中过早展开“元组里包含可变对象时的特殊情况”,否则可能增加理解负担。

3. **例子清晰,但列表和元组例子不够对称**
   - 列表例子展示了修改和添加,很直观。
   - 元组例子只展示了访问和错误修改,略微简单。
   - 可以让两个例子使用相似场景,比如:
     - 列表表示“购物车”,因为商品可能增加或删除;
     - 元组表示“出生日期”或“坐标”,因为通常不会改变。
   - 这样更符合“适合初学者”的要求,也更容易理解使用场景。

4. **可以补充一个生活化类比**
   - 初学者可能对“可变”和“不可变”不敏感。
   - 可以用简单类比帮助理解,例如:
     - 列表像购物清单,可以随时加减;
     - 元组像身份证上的出生日期,确定后一般不改。
   - 这会让答案更友好。

5. **表达上有一点可以更清楚**
   - “用 `[]`”和“用 `()`”可以改成“列表通常用 `[]` 创建,元组通常用 `()` 创建”。
   - 因为严格来说,元组也可以不用括号创建,例如 `1, 2, 3` 也是元组。
   - 但对于初学者,先说“通常用 `()`”更稳妥。

6. **可以提醒单元素元组的特殊写法**
   - 如果面向初学者,是否补充要看答案长度。
   - 单元素元组需要写成:
     ```python
     x = (1,)
     ```
     而不是:
     ```python
     x = (1)
     ```
   - 这不是原问题必须内容,但属于元组学习中常见易错点,可以作为补充说明。

7. **没有明显事实错误**
   - 初稿中关于列表可变、元组不可变、访问元素、修改元组会报错等内容都是正确的。
   - 代码示例也没有问题。

8. **可以更明确说明适用场景**
   - 初稿最后已经总结:
     - list 适合以后可能改变的数据;
     - tuple 适合固定不变的数据。
   - 这很好。
   - 但可以稍微具体化,例如:
     - list:购物车、学生名单、待办事项;
     - tuple:坐标、日期、RGB 颜色值。
   - 这样对初学者更有帮助。

总体来看,初稿已经能正确回答问题,结构清楚、示例简单。主要改进方向是:补充共同点、让例子更生活化、更对称,并在表述上稍微更严谨。

阶段 6:Revise 改进阶段,根据反思意见生成最终答案...

最终答案:
Python 中,**列表(list)**和**元组(tuple)**都可以用来存放多个数据。

它们的共同点:

- 都可以存放多个元素
- 都可以通过下标访问元素
- 都可以用 `for` 循环遍历
- 都可以存放不同类型的数据

主要区别是:**列表可以修改,元组创建后一般不能修改**。

---

## 1. 列表 list

列表通常用 `[]` 创建,适合存放以后可能会变化的数据,比如购物车、学生名单、待办事项。

```python
shopping_cart = ["苹果", "香蕉", "牛奶"]

shopping_cart.append("面包")   # 添加元素
shopping_cart[0] = "橙子"      # 修改元素

print(shopping_cart)
```

输出:

```python
['橙子', '香蕉', '牛奶', '面包']
```

列表就像购物清单,可以随时增加、删除或修改。

---

## 2. 元组 tuple

元组通常用 `()` 创建,适合存放固定不变的数据,比如出生日期、坐标、RGB 颜色值。

```python
birthday = (2000, 5, 20)

print(birthday[0])  # 访问第一个元素
```

输出:

```python
2000
```

如果尝试修改元组中的元素,会报错:

```python
birthday[0] = 1999  # 报错:元组不能修改
```

元组本身是不可变的,不能增加、删除或替换元素。

---

补充一个常见易错点:如果只有一个元素的元组,要写逗号:

```python
x = (1,)   # 这是元组
y = (1)    # 这是整数
```

**一句话总结:列表适合存放会变化的数据,元组适合存放固定不变的数据。**
Reflecton的主要特点
- 自我检查:主动回看自己的答案,判断有没有逻辑错误、遗漏信息或表达不清的问题
- 提升结果质量:通过“生成—反思—修改”,通常可以让答案更完整、更准确
- 可以和其他范式结合:Reflection 可以和 ReAct、Plan-and-Solve 结合使用
| 方法 | 核心思想 | 侧重点 |
|---|---|---|
| ReAct | 边思考边行动 | 工具调用与环境反馈 |
| Plan-and-Solve | 先规划再执行 | 任务拆解与步骤执行 |
| Reflection | 先完成再反思 | 自我检查与结果改进 |
五、智能体框架
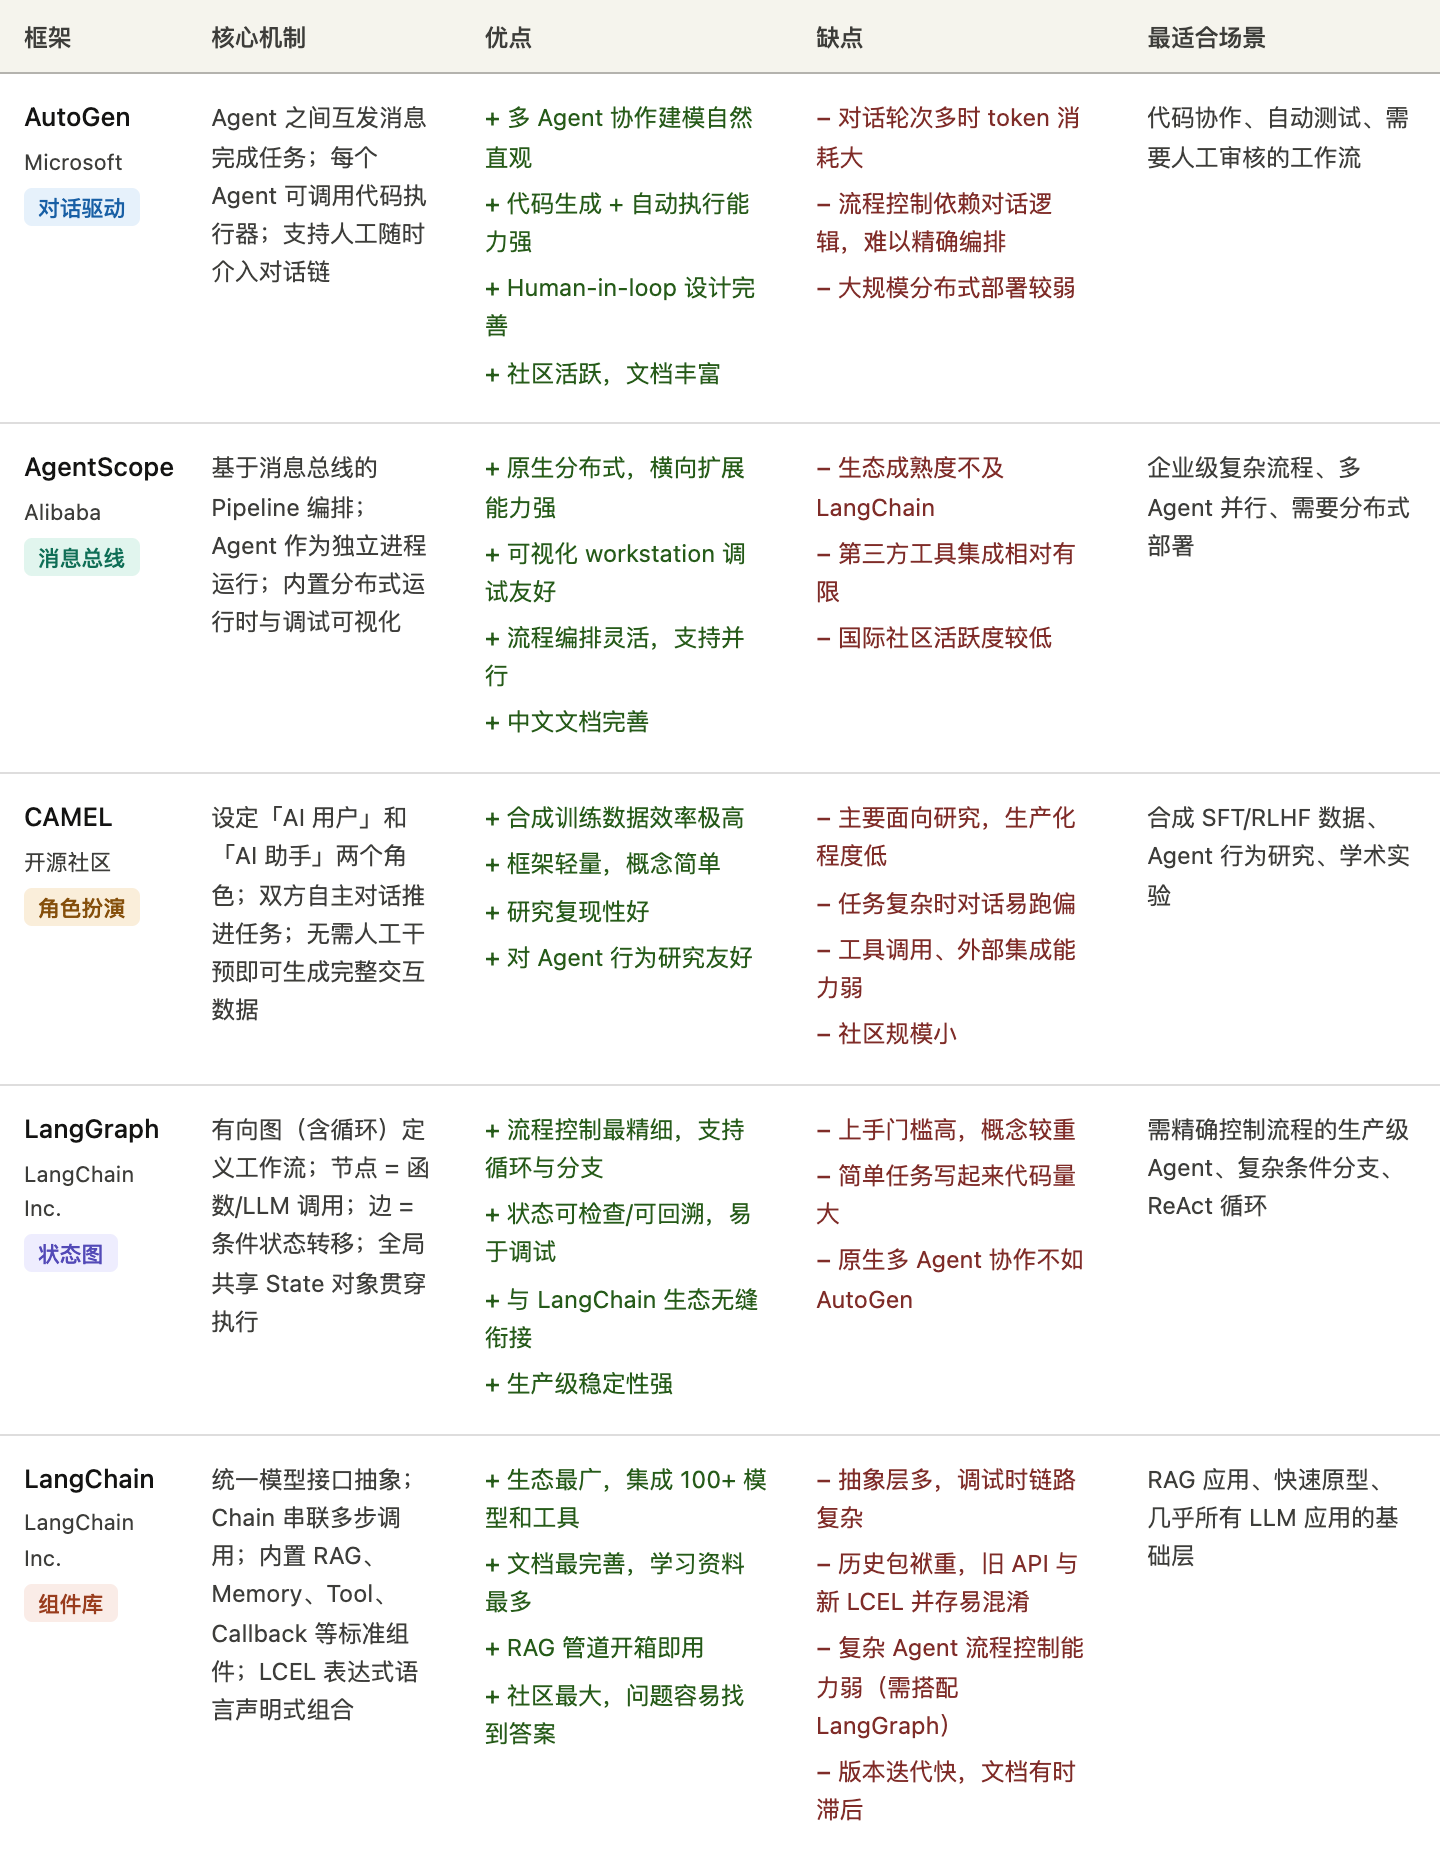
快速搭 RAG 或做原型,先用 LangChain,上手最快。需要精确控制 Agent 流程(循环、条件、状态回溯),选 LangGraph,二者可以叠用。多个 Agent 互相协作、需要代码执行或人工审核,AutoGen 更顺手。项目需要分布式部署或团队在国内,可以考虑 AgentScope。只是做研究、需要批量生成对话数据,CAMEL 最省力。
六、记忆与检索
人类智能的一个重要特征就是能够记住过去的经历,从中学习,并将这些经验应用到新的情况中。同样,一个真正智能的智能体也需要具备记忆能力。对于基于LLM的智能体而言,通常面临两个根本性局限:对话状态的遗忘和内置知识的局限
大语言模型虽然强大,但设计上是无状态的。这意味着,每一次用户请求(或API调用)都是一次独立的、无关联的计算。模型本身不会自动“记住”上一次对话的内容
Hello-Agent的记忆系统和RAG系统 记忆系统采用了四层架构设计:
HelloAgents记忆系统
├── 基础设施层 (Infrastructure Layer)
│   ├── MemoryManager - 记忆管理器(统一调度和协调)
│   ├── MemoryItem - 记忆数据结构(标准化记忆项)
│   ├── MemoryConfig - 配置管理(系统参数设置)
│   └── BaseMemory - 记忆基类(通用接口定义)
├── 记忆类型层 (Memory Types Layer)
│   ├── WorkingMemory - 工作记忆(临时信息,TTL管理)
│   ├── EpisodicMemory - 情景记忆(具体事件,时间序列)
│   ├── SemanticMemory - 语义记忆(抽象知识,图谱关系)
│   └── PerceptualMemory - 感知记忆(多模态数据)
├── 存储后端层 (Storage Backend Layer)
│   ├── QdrantVectorStore - 向量存储(高性能语义检索)
│   ├── Neo4jGraphStore - 图存储(知识图谱管理)
│   └── SQLiteDocumentStore - 文档存储(结构化持久化)
└── 嵌入服务层 (Embedding Service Layer)
    ├── DashScopeEmbedding - 通义千问嵌入(云端API)
    ├── LocalTransformerEmbedding - 本地嵌入(离线部署)
    └── TFIDFEmbedding - TFIDF嵌入(轻量级兜底)
RAG系统专注于外部知识的获取和利用:
HelloAgents RAG系统
├── 文档处理层 (Document Processing Layer)
│   ├── DocumentProcessor - 文档处理器(多格式解析)
│   ├── Document - 文档对象(元数据管理)
│   └── Pipeline - RAG管道(端到端处理)
├── 嵌入表示层 (Embedding Layer)
│   └── 统一嵌入接口 - 复用记忆系统的嵌入服务
├── 向量存储层 (Vector Storage Layer)
│   └── QdrantVectorStore - 向量数据库(命名空间隔离)
└── 智能问答层 (Intelligent Q&A Layer)
    ├── 多策略检索 - 向量检索 + MQE + HyDE
    ├── 上下文构建 - 智能片段合并与截断
    └── LLM增强生成 - 基于上下文的准确问答
1、智能体记忆
memory tool
Agent 可以使用的记忆工具接口
add:添加记忆search:搜索相关记忆summary:生成记忆摘要stats:查看记忆统计update:更新记忆remove:删除某条记忆forget:按策略遗忘consolidate:记忆整合,比如从工作记忆转为长期记忆
memory manager
tool接收指令, manager负责底层记忆系统的核心逻辑- 记忆存到哪里;
- 用什么类型存
- 怎么检索
- 怎么排序
- 哪些记忆该遗忘
- 哪些短期记忆该转为长期记忆
- 不同用户、不同会话的记忆如何隔离
记忆类型
| 记忆类型 | 存什么 | 核心作用 | 生命周期 | 存储 / 检索方式 |
|---|---|---|---|---|
| 工作记忆 | 当前问题、刚刚说过的话、临时计划、中间结果 | 保存当前任务、当前对话中的临时上下文 | 很短,通常随会话结束或 TTL 到期清理 | 纯内存存储;支持 TTL 自动清理;检索时可结合 TF-IDF 和关键词匹配 |
| 情景记忆 | 某次对话、某次任务、某个学习里程碑、某次工具调用结果 | 保存具体发生过的事件和经历 | 较长,可长期保存 | SQLite + Qdrant;支持时间序列、会话级检索、结构化过滤和语义向量检索 |
| 语义记忆 | 用户偏好、长期指令、领域知识、概念关系 | 保存抽象知识、事实、概念、规则 | 长期,稳定性强 | Qdrant 向量库 + Neo4j 图数据库;支持向量检索和图关系推理 |
| 感知记忆 | 图片、音频、代码截图、文件特征、多媒体内容 | 保存多模态感知信息 | 根据重要性和存储空间动态管理 | 按模态分离向量存储;支持同模态和跨模态检索 |
2、RAG
检索增强生成(Retrieval-Augmented Generation),先查资料再回答问题
- 无rag:依赖训练时学到的“知识”,可能 过时、不完整,甚至会幻觉
- 有rag:把外部知识库、文档、数据库、网页等接进来,让模型回答前先检索相关资料,再基于资料生成答案
RAG流程:
- 原始文档-文档清洗-文本切块 Chunking-转成向量 Embedding-存入向量(文本的语义坐标)数据库
- 用户问题-问题转向量-去向量数据库检索相似内容-取回相关片段-把片段和问题交给大模型-生成答案
RAG与微调:
| 方式 | 作用 | 类比 |
|---|---|---|
| RAG | 让模型查资料后回答 | 开卷考试 |
| 微调 Fine-tuning | 改变模型的行为、风格或能力 | 训练学生的答题习惯 |
| Prompt | 临时告诉模型怎么回答 | 考前给答题要求 |
RAG核心组件:
- 文档加载器
- 文本切分器
- Embedding 模型(将单词转换为向量)
- 向量数据库
- 检索器 Retriever
- 重排序器 Reranker
- 大模型 LLM
- 答案生成与引用模块
- 评估模块
应用场景:
企业知识库问答
客服机器人
文档问答
法律/医疗/金融资料查询
论文助手
代码库问答
个人笔记问答
七、上下文工程
1、noteTool 结构化笔记
NoteTool 是为”长时程任务”提供的结构化外部记忆组件。它以 Markdown 文件作为载体,头部使用 YAML 前置元数据记录关键信息,正文用于记录状态、结论、阻塞与行动项等内容。这种设计结合了人类可读性、版本控制友好性和易于回注上下文的特性,是构建长时程智能体的重要工具。
前面提到的MemoryTool 主要关注对话式记忆——短期工作记忆、情景记忆和语义记忆。对于需要长期追踪、结构化管理的项目式任务,我们需要一种更轻量、更人类友好的记录方式。
NoteTool 填补了这个差距,它提供了:
- 结构化记录:使用 Markdown + YAML 格式,既适合机器解析,也方便人类阅读和编辑
- 版本友好:纯文本格式,天然支持 Git 等版本控制系统
- 低开销:无需复杂的数据库操作,适合轻量级的状态追踪
- 灵活分类:通过
type和tags灵活组织笔记,支持多维度检索
最佳实践:在实际使用 NoteTool 时,以下最佳实践能帮助您构建更强大的长时程智能体:
-
合理的笔记分类:
- `task_state`:记录阶段性进展和状态 - `conclusion`:记录重要的结论和发现 - `blocker`:记录阻塞问题,优先级最高 - `action`:记录下一步行动计划 - `reference`:记录重要的参考资料 -
定期清理和归档:
- 对于已解决的 blocker,更新为 conclusion - 对于过时的 action,及时删除或更新 - 使用 tags 进行版本管理,如 `["v1.0", "completed"]` -
与 ContextBuilder 的配合:
- 在每轮对话前检索相关笔记 - 根据笔记类型设置不同的相关性分数(blocker > action > conclusion) - 限制笔记数量,避免上下文过载 -
人机协作:
- 笔记是人类可读的 Markdown 格式,支持手动编辑 - 使用 Git 进行版本控制,追踪笔记的演化 - 在关键阶段,人工审核 Agent 生成的笔记 -
自动化工作流:
         - 定期生成笔记摘要报告
         - 基于笔记自动生成项目进度文档
         - 将笔记内容同步到其他系统(如 Notion、Confluence)
2、TerminalTool 文件系统访问
在许多实际场景中,智能体需要即时访问和探索文件系统——查看日志文件、分析代码库结构、检索配置文件等。这就是 TerminalTool 的用武之地。
没有 TerminalTool 时,Agent 可能只能依赖你贴给它的代码,或者依赖提前建好的 RAG 索引。 有 TerminalTool 时,它可以这样逐步探索:
ls -la
find . -name "*.py"
grep -r "login" .
head -n 50 src/auth.py区别:
| 工具 | 主要作用 | 类比 |
|---|---|---|
| RAG | 从知识库里检索相关片段 | 查资料库 |
| MemoryTool | 保存长期记忆 | 记住经验 |
| NoteTool | 保存结构化笔记 | 写项目笔记 |
| TerminalTool | 实时访问文件系统 | 打开终端查文件 |
应用场景:
代码库探索
日志分析
数据文件预览
长程智能体任务
八、智能体通讯协议
如果没有通信协议,每接入一个新服务,都要单独写一个 Tool 类。比如接 GitHub 要写 GitHubTool,接数据库要写 DatabaseTool,接天气 API 要写 WeatherTool。这样会带来代码重复、维护困难、无法复用、扩展性差等问题
| 协议 | 连接对象 | 解决的问题 | 适合场景 |
|---|---|---|---|
| MCP | Agent ↔ 工具 | 统一调用外部工具 | 文件、数据库、API、GitHub |
| A2A | Agent ↔ Agent | 多智能体点对点协作 | 研究员 + 撰写员 + 编辑 |
| ANP | Agent ↔ Agent 网络 | 服务发现、路由、扩展 | 大规模开放 Agent 网络 |
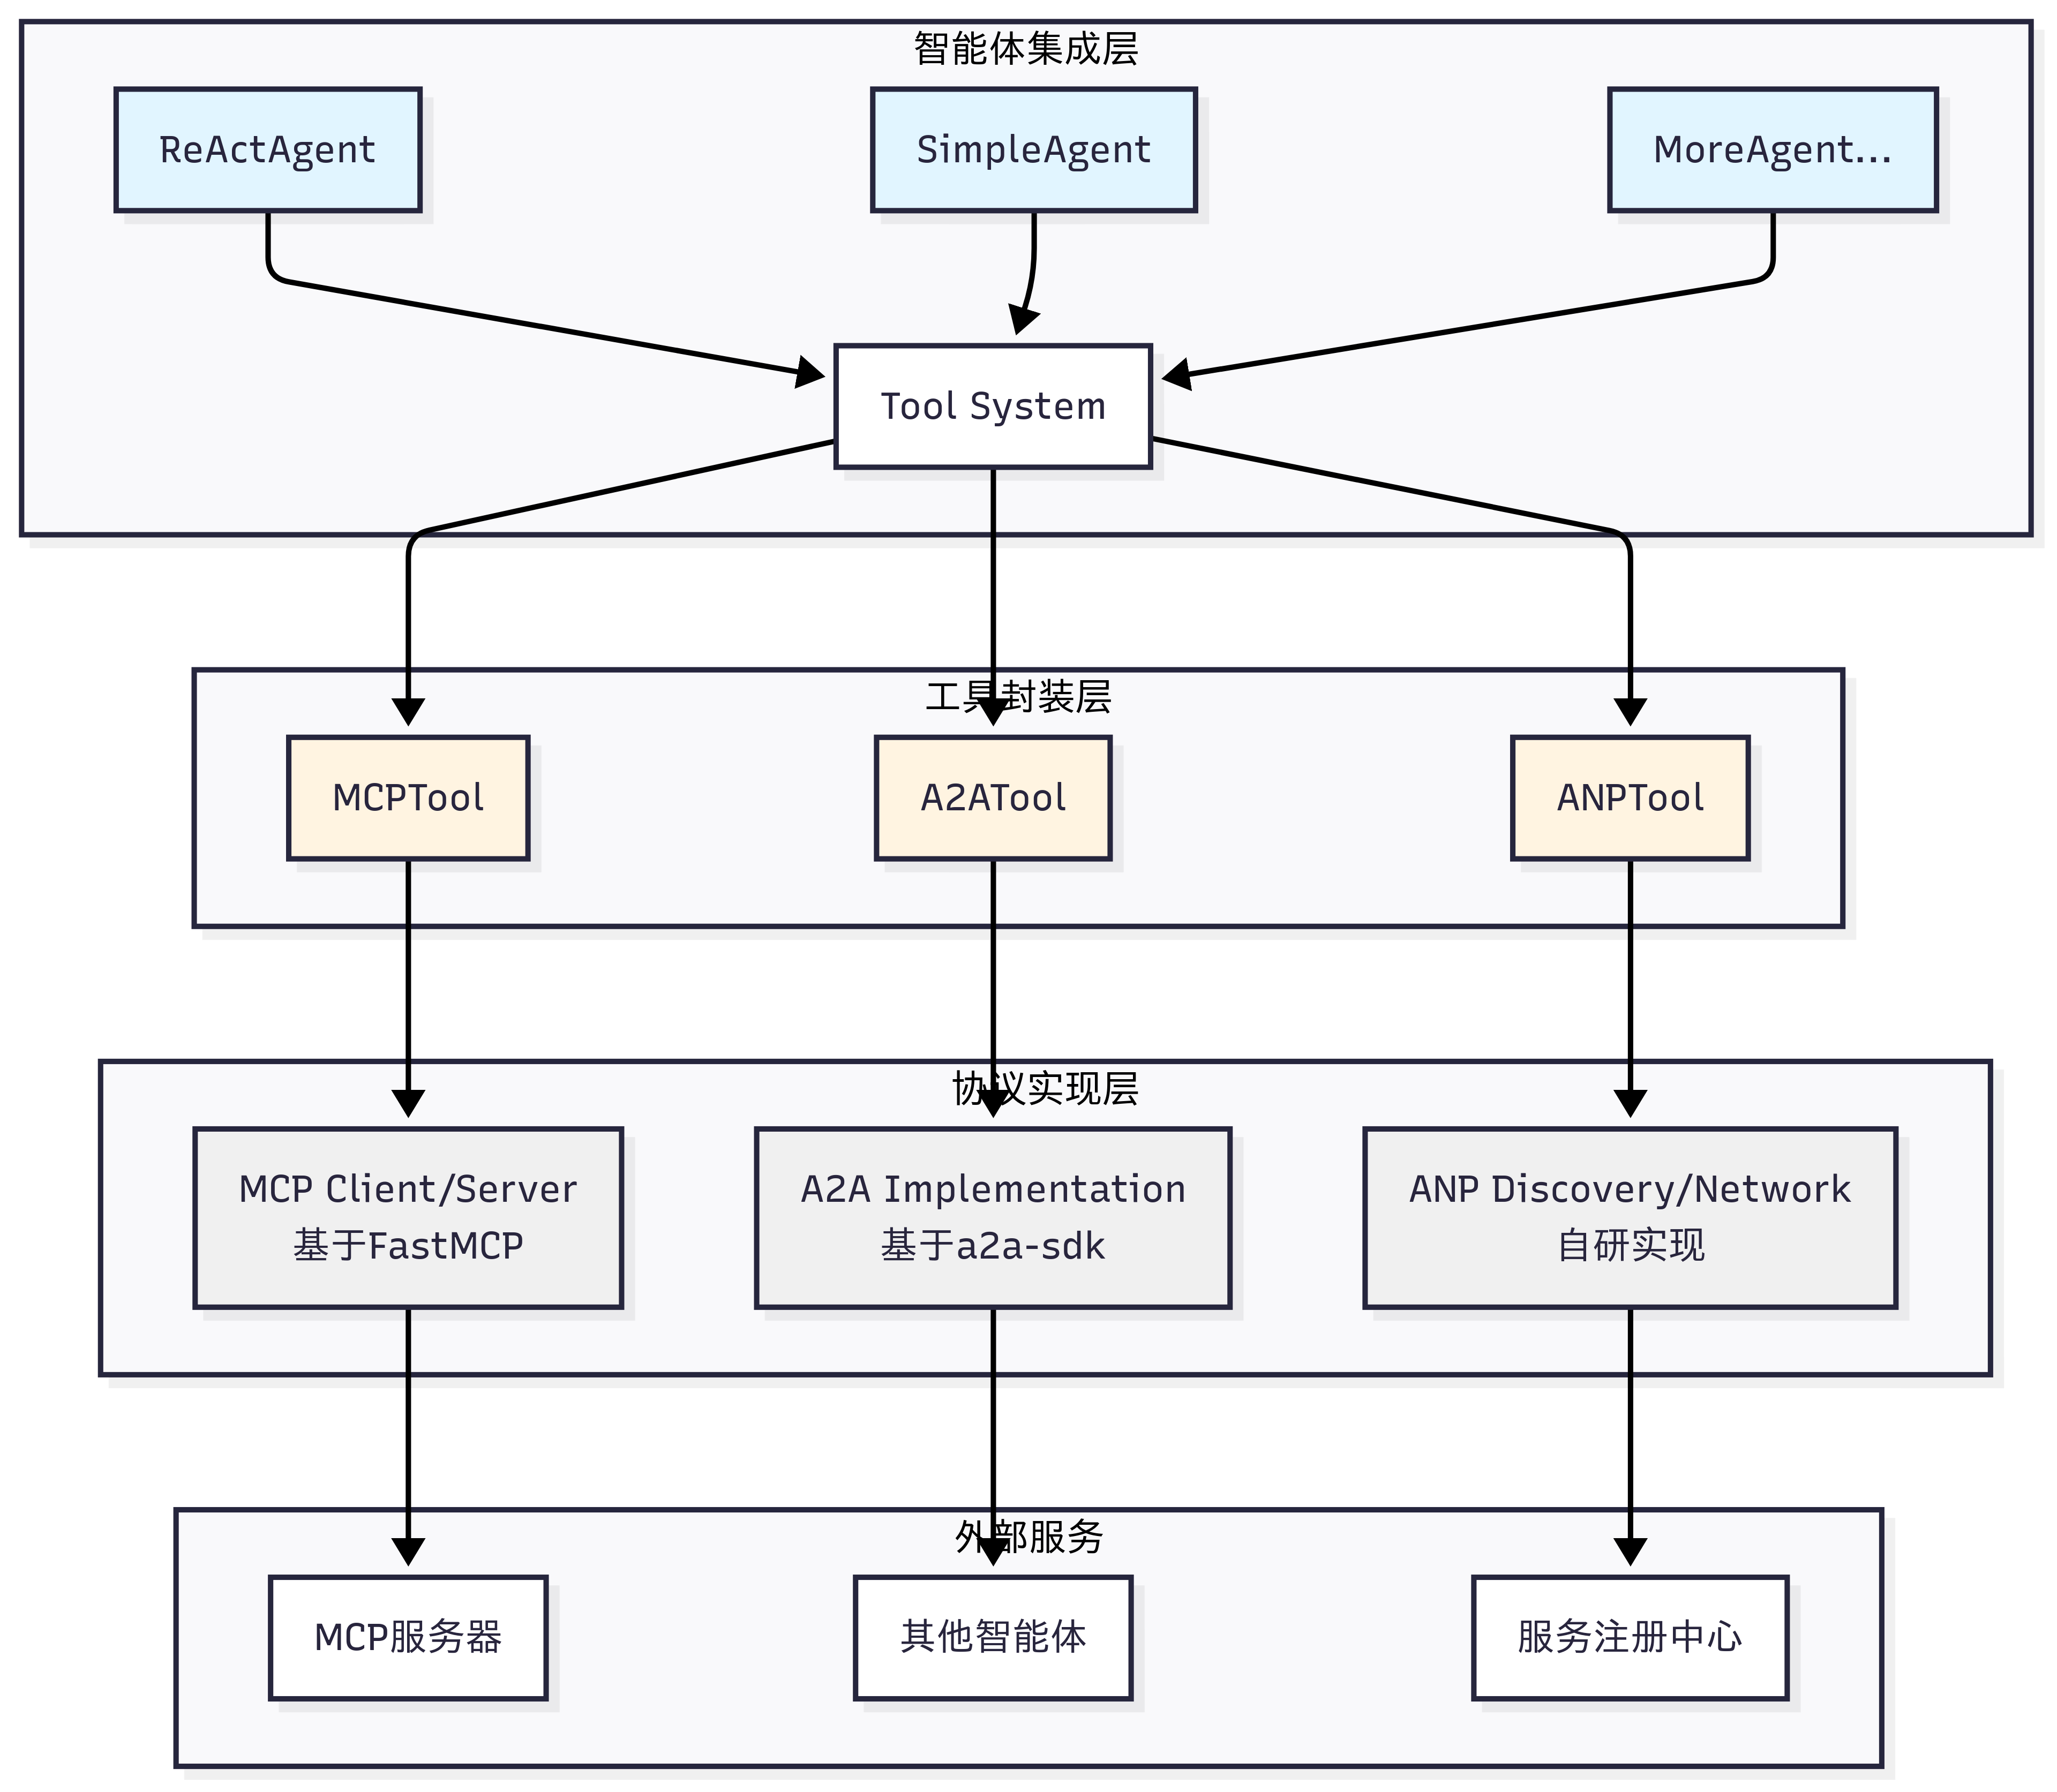
1、MCP(Model Context Protocol)
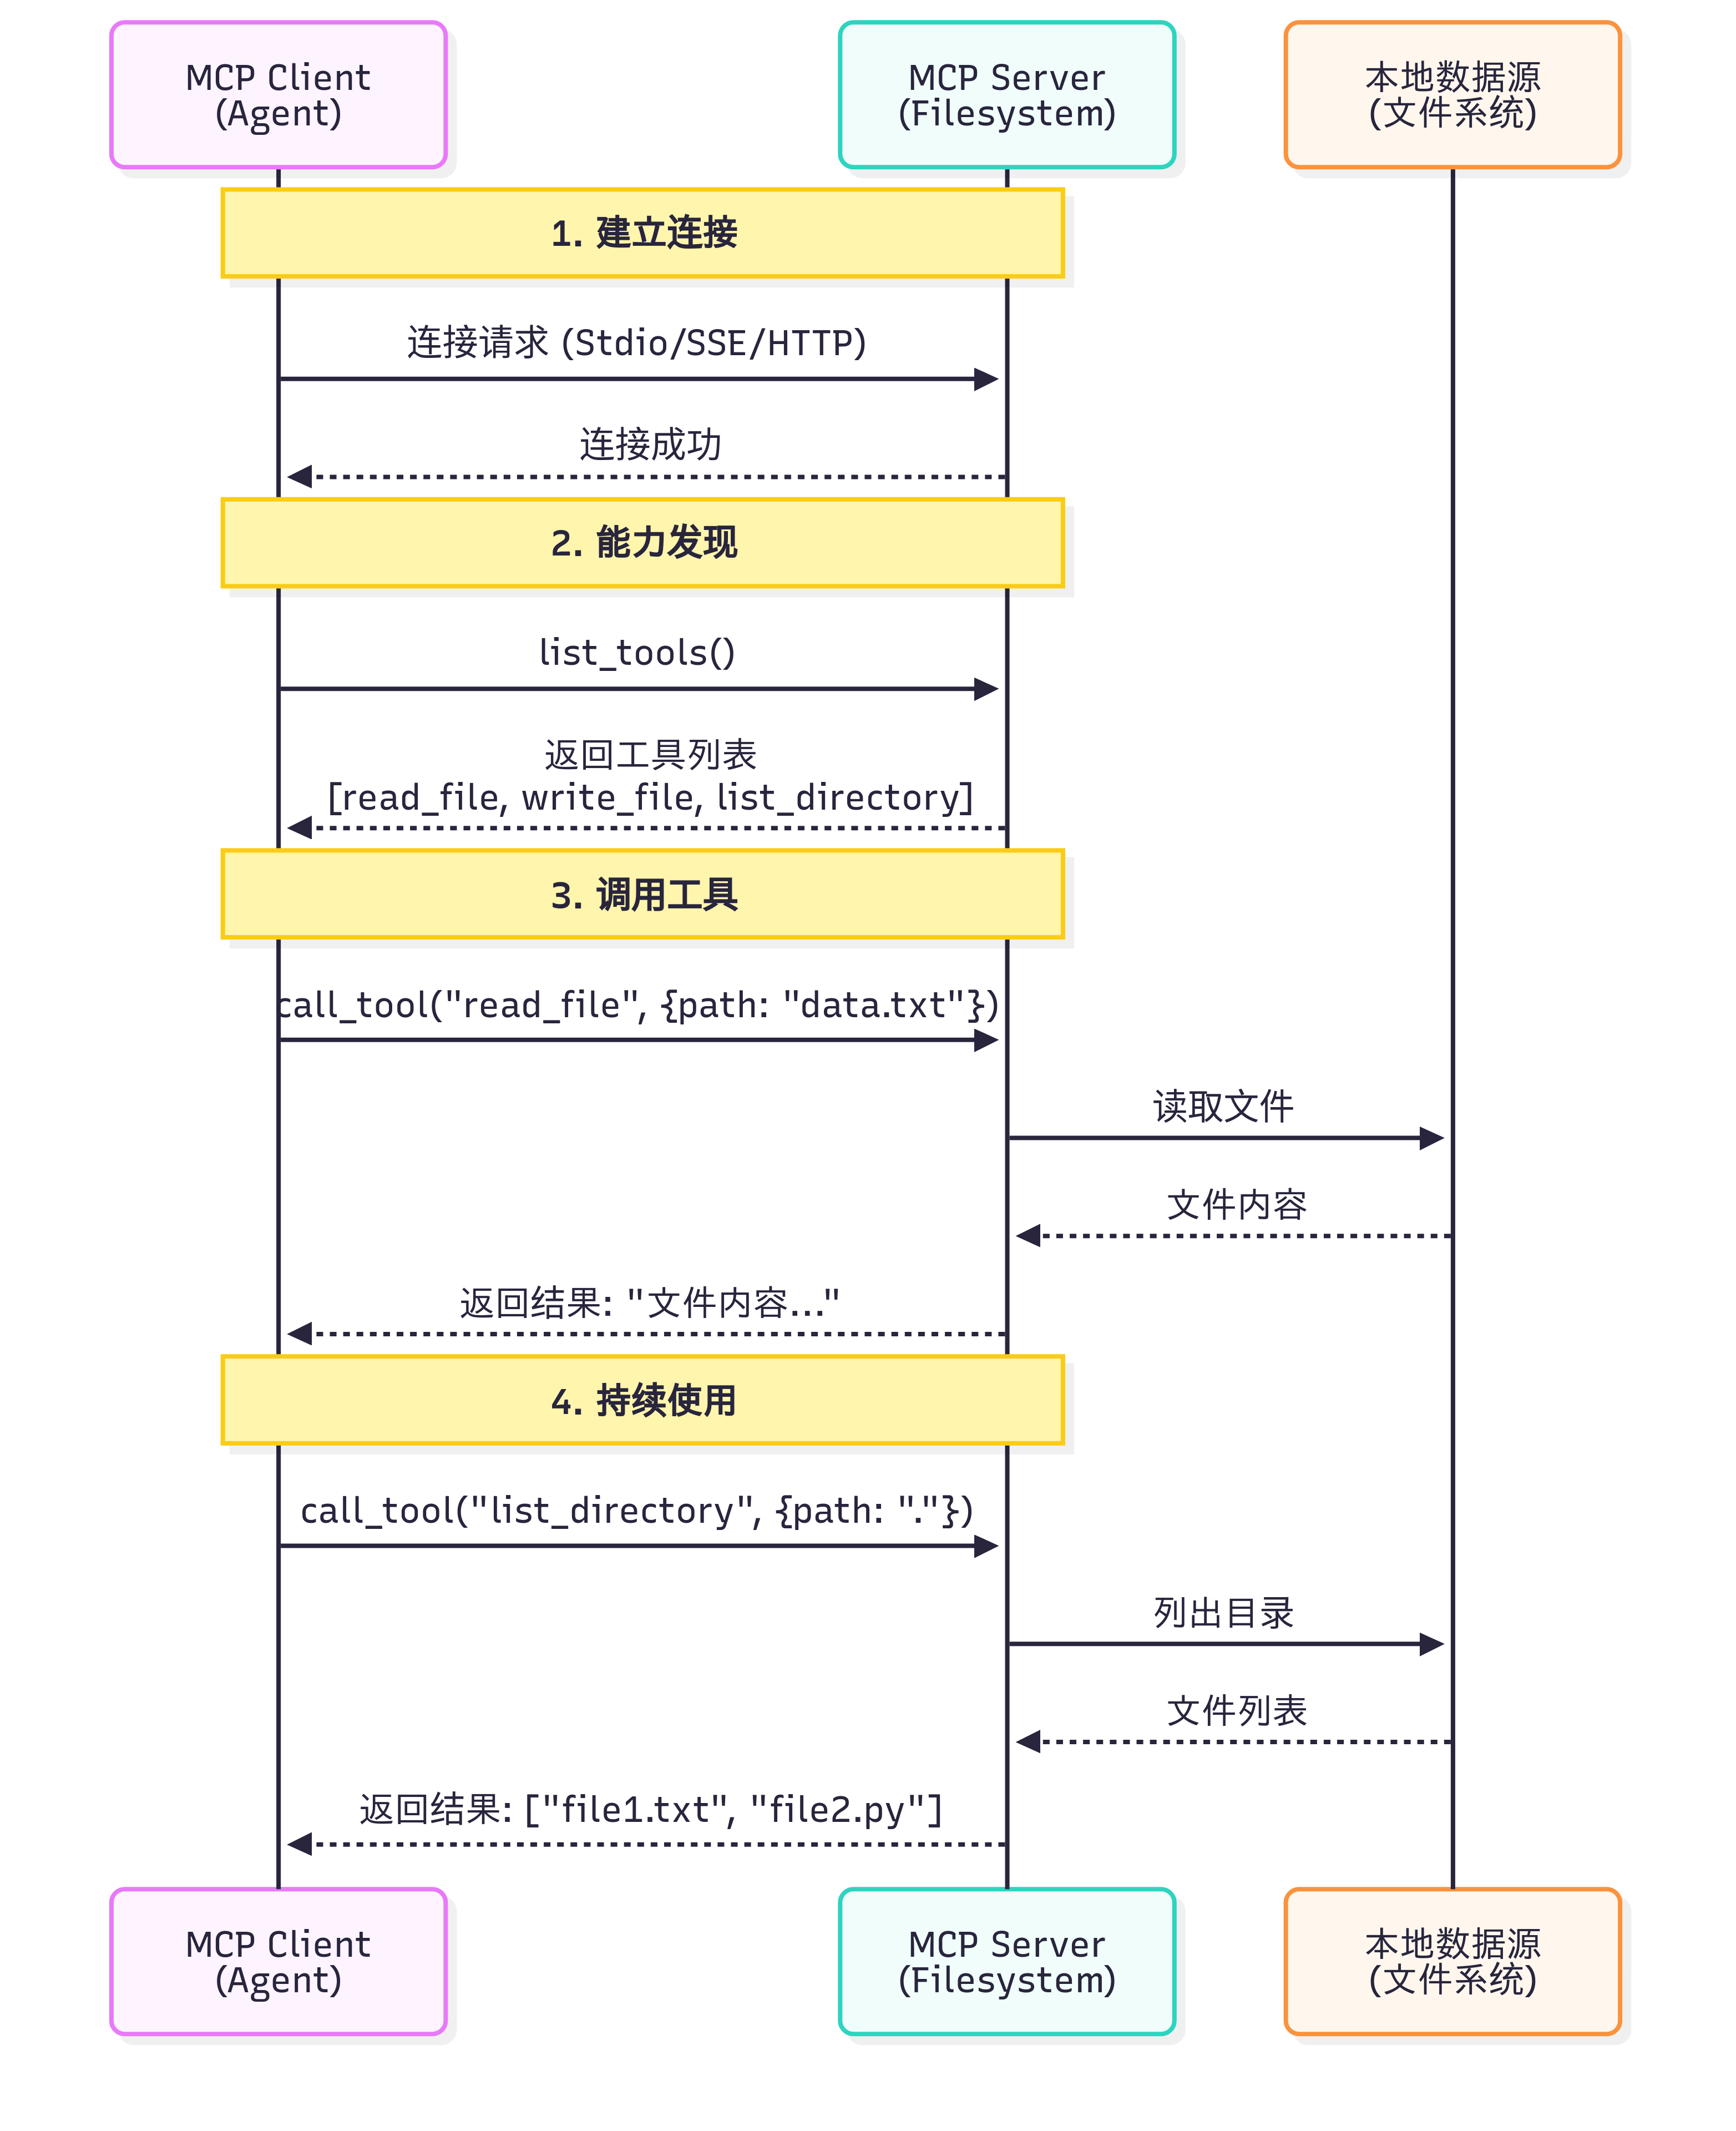
主要解决: Agent 如何标准化地访问外部工具、资源和服务
MCP 的设计哲学是”上下文共享”。它不仅仅是一个 RPC(远程过程调用)协议,更重要的是它允许智能体和工具之间共享丰富的上下文信息
MCP工作流程:
2、A2A(Agent-to-Agent Protocol)
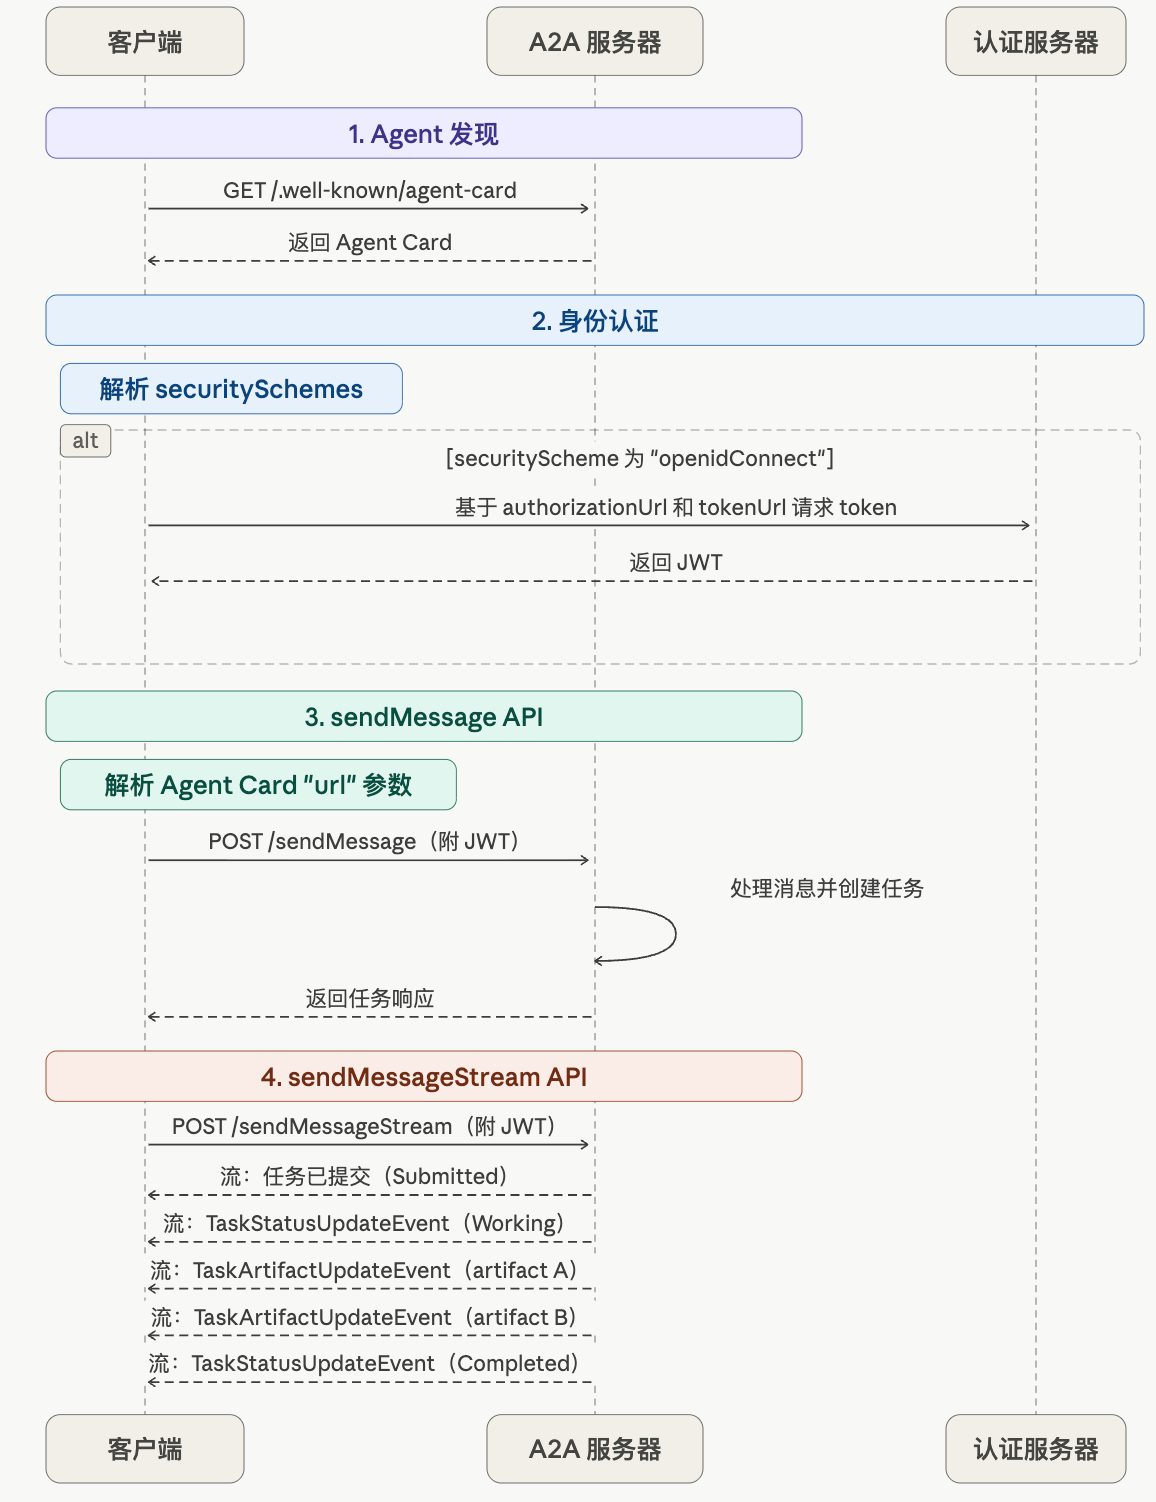
主要解决:多个 Agent 之间如何直接通信、协作、委托任务
A2A 生命周期:
3、ANP(Agent Network Protocol)
主要解决:在一个大规模 Agent 网络中,如何发现、选择、路由合适的 Agent
九、训练与评估 了解
训练:
- Agentic RL(基于强化学习的智能体训练)要解决的核心问题。本章将为 HelloAgents 框架引入强化学习训练能力,让你能够训练出具备推理、工具使用等高级能力的智能体
- 数据集和奖励函数是强化学习训练的两大基石。数据集定义了智能体要学习的任务,奖励函数定义了什么是好的行为。
- SFT训练,监督微调(Supervised Fine-Tuning, SFT)是强化学习训练的第一步,也是最重要的基础。SFT 让模型学习任务的基本格式、对话模式和初步的推理能力。没有 SFT 的基础,直接进行强化学习往往会失败,因为模型连基本的输出格式都不会。
- GRPO训练,在完成 SFT 训练后,我们已经得到了一个能够生成结构化答案的模型。但是,SFT 模型只是学会了”模仿”训练数据中的推理过程,并没有真正学会”思考”。强化学习可以让模型通过试错来优化推理策略,从而超越训练数据的质量。
智能体性能评估:
- 工具调用能力评估:工具调用是智能体的核心能力之一。智能体需要理解用户意图,选择合适的工具,并正确构造函数调用
-
- BFCL (Berkeley Function Calling Leaderboard)[1]:UC Berkeley 推出,包含 1120+测试样本,涵盖 simple、multiple、parallel、irrelevance 四个类别,使用 AST 匹配算法评估,数据集规模适中,社区活跃。
- ToolBench[2]:清华大学推出,包含 16000+真实 API 调用场景,覆盖真实世界的复杂工具使用场景。
- API-Bank[3]:Microsoft Research 推出,包含 53 个常用 API 工具,专注于评估智能体对 API 文档的理解和调用能力。
- 通用能力评估:评估智能体在真实世界任务中的综合表现,包括多步推理、知识运用、多模态理解等能力
-
- GAIA (General AI Assistants)[4]:Meta AI 和 Hugging Face 联合推出,包含 466 个真实世界问题,分为 Level 1/2/3 三个难度级别,评估多步推理、工具使用、文件处理、网页浏览等能力,使用准精确匹配(Quasi Exact Match)算法,任务真实且综合性强。
- AgentBench[5]:清华大学推出,包含 8 个不同领域的任务,全面评估智能体的通用能力。
- WebArena[6]:CMU 推出,评估智能体在真实网页环境中的任务完成能力和网页交互能力。
- 多智能体协作评估:评估多个智能体协同工作的能力
-
- ChatEval[7]:评估多智能体对话系统的质量。
- SOTOPIA[8]:评估智能体在社交场景中的互动能力。
- 自定义协作场景:根据具体应用场景设计的评估任务。
- 常用评估指标:不同基准使用不同的评估指标
-
- 准确性指标:Accuracy(准确率)、Exact Match(精确匹配)、F1 Score(F1 分数),用于衡量答案的正确性。
- 效率指标:Response Time(响应时间)、Token Usage(Token 使用量),用于衡量执行效率。
- 鲁棒性指标:Error Rate(错误率)、Failure Recovery(故障恢复),用于衡量容错能力。
- 协作指标:Communication Efficiency(通信效率)、Task Completion(任务完成度),用于衡量协作效果。